'commit'
This commit is contained in:
 HuangHai
78
TangDou/AcWing/DP/Tree/51NOD1588.cpp
Normal file
78
TangDou/AcWing/DP/Tree/51NOD1588.cpp
Normal file
@@ -0,0 +1,78 @@
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
|
||||
typedef long long LL;
|
||||
const int N = 1e6 + 10, M = N << 1;
|
||||
|
||||
// 链式前向星
|
||||
int e[M], h[N], idx, w[M], ne[M];
|
||||
void add(int a, int b, int c = 0) {
|
||||
e[idx] = b, ne[idx] = h[a], w[idx] = c, h[a] = idx++;
|
||||
}
|
||||
|
||||
LL s[N], f[N];
|
||||
int sz[N];
|
||||
int st[N];
|
||||
|
||||
void dfs1(int u) {
|
||||
st[u] = 1;
|
||||
sz[u] = 1; // u节点自己加入
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
// 先执行噢
|
||||
dfs1(v);
|
||||
// 统计u子树中节点数量
|
||||
sz[u] += sz[v];
|
||||
// 幸运边
|
||||
if (w[i])
|
||||
s[u] += sz[v]; // v子树中所有节点,都可以为s[u]贡献力量
|
||||
else
|
||||
s[u] += s[v]; // v这个点是指望不上的,它的子树中的贡献力量
|
||||
}
|
||||
}
|
||||
|
||||
void dfs2(int u) {
|
||||
st[u] = 1;
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
if (w[i]) // 幸运边
|
||||
f[v] = sz[1] - sz[v]; // 容斥原理
|
||||
else
|
||||
f[v] = f[u] + s[u] - s[v]; // 还是容斥原理吧~
|
||||
// 最后执行噢
|
||||
dfs2(v);
|
||||
}
|
||||
}
|
||||
|
||||
// 幸运数字是由 4 和 7 组成的正整数
|
||||
int check(int n) {
|
||||
while (n) {
|
||||
if (n % 10 != 4 && n % 10 != 7) return 0;
|
||||
n /= 10;
|
||||
}
|
||||
return 1;
|
||||
}
|
||||
|
||||
int main() {
|
||||
memset(h, -1, sizeof h);
|
||||
int n;
|
||||
cin >> n;
|
||||
for (int i = 1; i < n; i++) { // n-1条边
|
||||
int a, b, c;
|
||||
cin >> a >> b >> c;
|
||||
c = check(c); // 如果一条边的权值是一个幸运数字,那么我们就说这条边是一条幸运边
|
||||
add(a, b, c), add(b, a, c);
|
||||
}
|
||||
memset(st, 0, sizeof st);
|
||||
dfs1(1);
|
||||
memset(st, 0, sizeof st);
|
||||
dfs2(1);
|
||||
|
||||
LL ans = 0;
|
||||
for (int i = 1; i <= n; i++) ans += s[i] * (s[i] - 1) + f[i] * (f[i] - 1) + s[i] * f[i] * 2;
|
||||
printf("%lld\n", ans);
|
||||
return 0;
|
||||
}
|
||||
1
TangDou/AcWing/DP/Tree/51NOD1588.drawio
Normal file
1
TangDou/AcWing/DP/Tree/51NOD1588.drawio
Normal file
@@ -0,0 +1 @@
|
||||
<mxfile host="Electron" modified="2023-03-10T07:32:33.972Z" agent="5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) draw.io/20.3.0 Chrome/104.0.5112.114 Electron/20.1.3 Safari/537.36" etag="2oZHw83CcRngu95UCd43" version="20.3.0" type="device"><diagram id="yXZ4yNBZ55WKePyJ4ORU" name="第 1 页">7Vzdb9s2EP9b9kCgfXAgkvqgHm3HWYFtWIc8rH0aaImyhciSJ9GO079+JEXJEqXETuuPpBMQ1CJ5IsW7+/2ou7ML8HS1+zWn6+UfWcgSgKxwB/AtQAjaCAH5Z4VPZQ/xnLJjkcehFtp33MffmO60dO8mDlnREuRZlvB43e4MsjRlAW/10TzPHttiUZa0V13TBet03Ac06fb+HYd8qXuh6+8HPrF4sdRLE+SVAytaCeudFEsaZo+NLjwDeJpnGS+vVrspS6TyKr2U9909M1o/WM5SfswNvy0s709+D7f/BFYabf76ffklG2G9jS1NNnrH+mn5U6WCPNukIZOzQIAnj8uYs/s1DeToozC66FvyVaKHQ1osa9mC59lDrTdH9ERZyrWRERZtvTrLOds9uy9Ya0u4GctWjOdPQkTf4GLtUdrDaoU/7u2FLS2zbJgK+lqQah9Z1HPv1SgutCZfoVXYUeqmo1UxjfBhdlijtFiXjh3FO6nZlg7JaXRYw+0FHTpWV4XOuTSIe9zSTbjefUuT7r+brBoYFUovYyEAvfVOKacaF1cL+QnBzAHkDkw8MPMAQWDig5kNJgRMxmDmgrEle/Rq4uHLBct737YVod9GAukakfQYkZzLiPZhbmFpOJYsLVppljKTQAxi+Uw5Z3mqepCFOwwjdDPZs5XV1jL0RJvtYv5Fjt04uvVVS8rr212z8aQbBac5r55ynmTBQ9V5FyfV45U7Y2HnNDGMJ3afbfKAHWYPscCC8UMY6TrDkZDNWUJ5vG0/bp8L6BU+Z7ECnvY1x2szhm0bXlRuU9/VPJaMiVzUngibrFzqoTOR8sh629/vpG7HSbeVoc4B80i4zDRLslxNjEOHkdCuHbkxQtAcu+6JiMGgd+z416V371XMECS0KOKgrekjcd5AOXwR5UKV+VODGmTza3Nsf5tqVfddAfjuAPwTAB/2IL/HDc+F/IgELAj6kD8nju1Yp0E+tt4Y8uHFoA+Phv4VIAyvimGEvBssnAFbtmdh7Ar/bL39e+jG9TzX9R3kuy72vg/g2AS4yRTnBnhfbFu+1s/zY0IIhJ8JIappijVNeycKSjTLSfLF/IPYt9iCVX18VFNYarWIruLkqRT9xJIt43FAG+M9T6MHykXlSJrlK5o0xrY0j6n4TOIF5Ztc5k9elAvo+jmRR+19ctC2SrRYCZPv4SOx/SBOF907s3y9pKmeEpV9gsP4KBa4TfVsVrUdNcJzcUMk5qhmU8FAiQiVxGlM9ZjlYXvxei7xvPOHWEwn5yyZdaQx1ZKb0+BhoXhkZNgK2aQ0E7J9feFUFlOzhizIcoG+LB3xZRw8pKzQjxenMY8rHZiyDXu9KNd4nJZclGSUm8oJ42Kd0KdKPInFALJ+iVfrLOc05b3euxmJK7qS55dqb2XU6xMwvpORsYh9RSg8E9HwHRAnsryYqRBZRMxTQKYqeibA9+WFuGXiF8CZbIBzq2RtMIYqrp6C8ayOq4tvQmarZFTPeNwIsEsUPRNgS/W02b99XmpdNA9X3UWF98tQMWGR2qU4RgW0krHuXsVhmDx3rrdPmMvntAzmtHE3kq9TNs3zAZ/r2EbdlNbApQOXDlza5VJFcOT2AqT6Yftx4NPj+NQMWq9PqKhLqMLC46n80z5kqXS06IFhVJzBkoHQHsvfmy2hYcseU0L3oqbsFiveeLnHM1R49XIP6isVDPWeQ2Z02vUep2vFi9Z7kNNjxaHgczBpVBHIwaxRCZNrZY0gxM+coq/NDEFIDA43ffLMqSH0f6j6uOZBaV8594uGss+Pwf+qSeOfCf6kC/+frvRD3LcG/yO+a/aOSz/Hw5hcE8Yeadd+cMtJkHuS0g8xAW5SxZkBXi03pCuHdOWQrjxV6SeqijhoIlxe1XSgaI721Z0hCfnCgewYB7Ldk3Wps1QXyVzhoaoz0ORAk+eq6rT5MqoqOmhSFXdGxUCcx0QyZuDZR5x+D3GaXzg6HXEeqt6MVVFvqN50c9aGLXtMednqDT4iaV0s6VpeRgnb6fB08rpItaVoU62vzw62MtQ12R0Xyl4r8CS2f0OI7UIHq39Ryw+gmQI6OtQU07bLIPDSwWY3m7Tn+gH2pZWMbzTBnt8mXRT2drdoq8KYwWoNq/lGxFIfqFez2usqjD9CzFW5sFs8PLKgAEGznHAj9fxiRUG1PrM8FqqSrlJmOI2jgTIS9WaO3YCwedRxjH0p6SQ5Tvud5DjNXz187+ECLTOJ7l72bLG7hUr5Wkl8MMZg5stvjI3tRv7lvROXcyLisg2zWT2vmSdKtYjm/kf8pd33/xUCnv0H</diagram></mxfile>
|
||||
124
TangDou/AcWing/DP/Tree/51NOD1588.md
Normal file
124
TangDou/AcWing/DP/Tree/51NOD1588.md
Normal file
@@ -0,0 +1,124 @@
|
||||
## [$51nod$ $1588$ 幸运树](https://www.51nod.com/Challenge/Problem.html#problemId=1588)
|
||||
|
||||
#### 【知识点】树形$dp$统计树上方案数
|
||||
|
||||
### 一、题目描述
|
||||
定义幸运数字只由$4$和$7$组成,比如$4$,$7$,$47$。 定义幸运数字只由$4$和$7$组成,比如$4$,$7$,$47$。
|
||||
|
||||
给一棵树,要我们找到三元组$(i,j,k)$,两两之间的路径中必须要有一条由幸运数字组成的边。问,存在多少组这样的三元组。
|
||||
|
||||
### 二、解题思路
|
||||
幸运数字好处理,$check$一下。关键是怎么找出贡献。
|
||||
|
||||
统计树上方案数,**一般先固定一个点**,比如$i$,然后再找另外两个点$j$和$k$,算出$i$这个点对应的贡献。
|
||||
|
||||
- 设$s[i]$为以$i$为根节点的子树中,有几个点到$i$的路径中存在幸运数字
|
||||
- 设$f[i]$为以$i$为根节点的子树外,有几个点到$i$的路径中存在幸运数字
|
||||
|
||||
这样,我们的 $j$ 和 $k$ 的选择就可以在$f$中选择,或者$g$中选择,或者在$f$和 $g$中选择。
|
||||
|
||||
即$i$的贡献为
|
||||
$$\large s[i]*(s[i]-1)+f[i]*(f[i]-1)+s[i]*f[i]*2$$
|
||||
|
||||
**解释**:
|
||||
- $s[i]*(s[i]-1)$ $j,k$都在以$i$为根节点的子树中
|
||||
- $f[i]*(f[i]-1)$ $j,k$都在以$i$为根节点的子树外
|
||||
- $s[i]*f[i]$ $j$在$i$为根节点的子树中,$k$在$i$为根节点的子树外
|
||||
- $f[i]*s[i]$ $k$在$i$为根节点的子树中,$j$在$i$为根节点的子树外
|
||||
|
||||
然后就是处理$f$和$g$。
|
||||
|
||||
#### $dfs$过程中
|
||||
|
||||
<font color='red' size=4><b>这些式子也还是都是满满的套路啦</b></font>
|
||||
|
||||
- 如果$u$和$v$的边是幸运数字,则$s[u]+=sz[v]$,否则$s[u]+=s[v]$
|
||||
|
||||
- 如果$v$和$u$的边是幸运数字,则$f[v]+=sz[1]-sz[v]$,否则$f[v]+=f[u]+s[u]−s[v]$
|
||||
|
||||
所以要先$dfs$一遍预处理$s$和$sz$,然后$dfs$一遍处理$f$,最后统计方案。
|
||||
|
||||
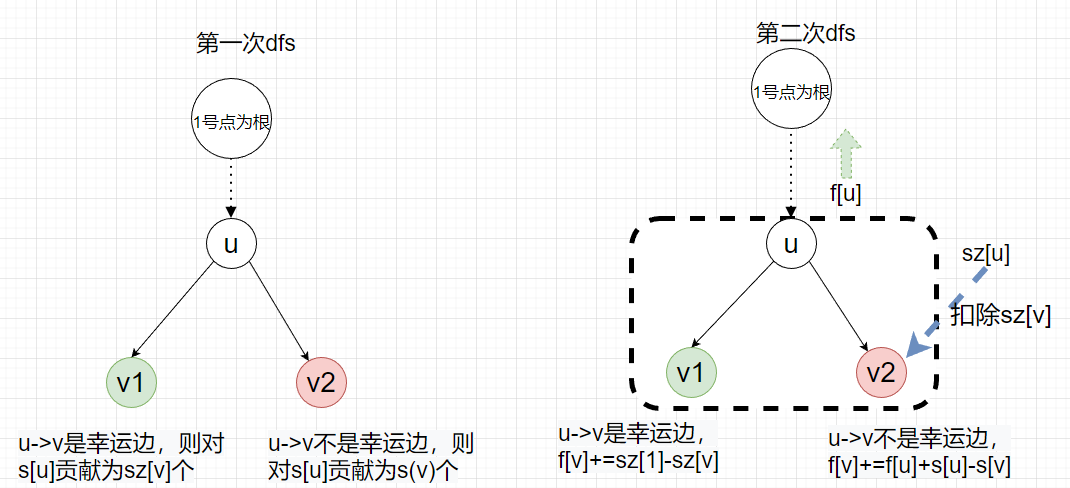
|
||||
|
||||
### 三、实现代码
|
||||
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
|
||||
typedef long long LL;
|
||||
const int N = 1e6 + 10, M = N << 1;
|
||||
|
||||
// 链式前向星
|
||||
int e[M], h[N], idx, w[M], ne[M];
|
||||
void add(int a, int b, int c = 0) {
|
||||
e[idx] = b, ne[idx] = h[a], w[idx] = c, h[a] = idx++;
|
||||
}
|
||||
|
||||
LL s[N], f[N];
|
||||
int sz[N];
|
||||
int st[N];
|
||||
|
||||
void dfs1(int u) {
|
||||
st[u] = 1;
|
||||
sz[u] = 1; // u节点自己加入
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
// 先执行噢
|
||||
dfs1(v);
|
||||
// 统计u子树中节点数量
|
||||
sz[u] += sz[v];
|
||||
// 幸运边
|
||||
if (w[i])
|
||||
s[u] += sz[v]; // v子树中所有节点,都可以为s[u]贡献力量
|
||||
else
|
||||
s[u] += s[v]; // v这个点是指望不上的,它的子树中的贡献力量
|
||||
}
|
||||
}
|
||||
|
||||
void dfs2(int u) {
|
||||
st[u] = 1;
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
if (w[i]) // 幸运边
|
||||
f[v] = sz[1] - sz[v]; // 容斥原理
|
||||
else
|
||||
f[v] = f[u] + s[u] - s[v]; // 还是容斥原理吧~
|
||||
// 最后执行噢
|
||||
dfs2(v);
|
||||
}
|
||||
}
|
||||
|
||||
// 幸运数字是由 4 和 7 组成的正整数
|
||||
int check(int n) {
|
||||
while (n) {
|
||||
if (n % 10 != 4 && n % 10 != 7) return 0;
|
||||
n /= 10;
|
||||
}
|
||||
return 1;
|
||||
}
|
||||
|
||||
int main() {
|
||||
memset(h, -1, sizeof h);
|
||||
int n;
|
||||
cin >> n;
|
||||
for (int i = 1; i < n; i++) { // n-1条边
|
||||
int a, b, c;
|
||||
cin >> a >> b >> c;
|
||||
c = check(c); // 如果一条边的权值是一个幸运数字,那么我们就说这条边是一条幸运边
|
||||
add(a, b, c), add(b, a, c);
|
||||
}
|
||||
memset(st, 0, sizeof st);
|
||||
dfs1(1);
|
||||
memset(st, 0, sizeof st);
|
||||
dfs2(1);
|
||||
|
||||
LL ans = 0;
|
||||
for (int i = 1; i <= n; i++) ans += s[i] * (s[i] - 1) + f[i] * (f[i] - 1) + s[i] * f[i] * 2;
|
||||
printf("%lld\n", ans);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
46
TangDou/AcWing/DP/Tree/Euler_YueShuCount.cpp
Normal file
46
TangDou/AcWing/DP/Tree/Euler_YueShuCount.cpp
Normal file
@@ -0,0 +1,46 @@
|
||||
#include <iostream>
|
||||
#include <cstdio>
|
||||
#include <cstring>
|
||||
using namespace std;
|
||||
const int N = 1010;
|
||||
|
||||
int primes[N], cnt; // primes[]存储所有素数
|
||||
bool st[N]; // st[x]存储x是否被筛掉
|
||||
int d[N]; // d[x]表示x的约数个数
|
||||
int num[N]; // num[x]表示x的最小质因数的个数
|
||||
int n;
|
||||
|
||||
//欧拉筛法+求约数个数
|
||||
void get_primes(int n) {
|
||||
d[1] = 1; // 1的约数只有1个,这个比较特殊
|
||||
|
||||
for (int i = 2; i <= n; i++) {
|
||||
if (!st[i]) {
|
||||
primes[cnt++] = i;
|
||||
// i是质数
|
||||
d[i] = 2; //约数个数是2个,一个是1,另一个是i
|
||||
num[i] = 1; //最小质因子个数是1,最小质因子就是自己i
|
||||
}
|
||||
|
||||
for (int j = 0; i * primes[j] <= n; j++) {
|
||||
st[i * primes[j]] = true;
|
||||
if (i % primes[j] == 0) {
|
||||
d[i * primes[j]] = d[i] / (num[i] + 1) * (num[i] + 2);
|
||||
num[i * primes[j]] = num[i] + 1;
|
||||
break;
|
||||
} else {
|
||||
// d[i * primes[j]] = d[i] * d[primes[j]]; 等价于下面的代码
|
||||
d[i * primes[j]] = d[i] * 2;
|
||||
num[i * primes[j]] = 1;
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
scanf("%d", &n);
|
||||
get_primes(n);
|
||||
//输出1~n之间所有数字的约数个数
|
||||
for (int i = 1; i <= n; i++) printf("%d %d\n", i, d[i]);
|
||||
return 0;
|
||||
}
|
||||
46
TangDou/AcWing/DP/Tree/Euler_YueShuSum.cpp
Normal file
46
TangDou/AcWing/DP/Tree/Euler_YueShuSum.cpp
Normal file
@@ -0,0 +1,46 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
typedef long long LL;
|
||||
|
||||
const int N = 1e3 + 10;
|
||||
|
||||
int primes[N], cnt;
|
||||
bool st[N];
|
||||
|
||||
int num[N]; //最小质因子p1组成的等比序列 p1^0+p1^1+...+p1^r1
|
||||
int sd[N]; //约数和
|
||||
|
||||
int n;
|
||||
|
||||
void get_primes(int n) {
|
||||
sd[1] = 1; // 1的约数只有自己,约数和是1
|
||||
|
||||
for (int i = 2; i <= n; i++) {
|
||||
if (!st[i]) {
|
||||
primes[cnt++] = i;
|
||||
//质数
|
||||
sd[i] = num[i] = i + 1; // 1和自身是约数,约数和为i+1; 同时因为i是质数,所以只有一个分拆项,并且分拆项内容=pj^0+pj^1=1+pj=1+i
|
||||
}
|
||||
for (int j = 0; primes[j] * i <= n; j++) {
|
||||
st[i * primes[j]] = true;
|
||||
|
||||
if (i % primes[j]) {
|
||||
sd[i * primes[j]] = sd[i] * sd[primes[j]]; //积性函数
|
||||
num[i * primes[j]] = primes[j] + 1;
|
||||
} else {
|
||||
sd[i * primes[j]] = sd[i] / num[i] * (num[i] * primes[j] + 1);
|
||||
num[i * primes[j]] = num[i] * primes[j] + 1;
|
||||
break;
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
scanf("%d", &n);
|
||||
get_primes(n);
|
||||
//约数和要不要自己本身,这里是不想要自己本身
|
||||
for (int i = 1; i <= n; i++) printf("%d ", sd[i] - i);
|
||||
puts("");
|
||||
return 0;
|
||||
}
|
||||
67
TangDou/AcWing/DP/Tree/P3349.cpp
Normal file
67
TangDou/AcWing/DP/Tree/P3349.cpp
Normal file
@@ -0,0 +1,67 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int N = 20, M = N << 1;
|
||||
#define int long long
|
||||
|
||||
// 链式前向星
|
||||
int e[M], h[N], idx, w[M], ne[M];
|
||||
void add(int a, int b) {
|
||||
e[idx] = b, ne[idx] = h[a], h[a] = idx++;
|
||||
}
|
||||
|
||||
int g[N][N];
|
||||
int f[N][N];
|
||||
int st[N];
|
||||
int flag[N];
|
||||
int n, m;
|
||||
// https://blog.csdn.net/Emm_Titan/article/details/123597082
|
||||
|
||||
void dfs(int u) {
|
||||
st[u] = 1;
|
||||
for (int i = 1; i <= n; i++) f[u][i] = flag[i] ^ 1;
|
||||
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
dfs(v);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
if (flag[i]) continue;
|
||||
int sum = 0;
|
||||
for (int j = 1; j <= n; j++)
|
||||
if (g[i][j] and !flag[j]) sum += f[v][j];
|
||||
f[u][i] *= sum;
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
signed main() {
|
||||
memset(h, -1, sizeof h);
|
||||
cin >> n >> m;
|
||||
int a, b;
|
||||
for (int i = 1; i <= m; i++) {
|
||||
cin >> a >> b;
|
||||
g[a][b] = g[b][a] = 1;
|
||||
}
|
||||
for (int i = 1; i < n; i++) {
|
||||
cin >> a >> b;
|
||||
add(a, b), add(a, b);
|
||||
}
|
||||
int ans = 0;
|
||||
for (int s = 0; s < (1 << n); s++) {
|
||||
for (int i = 0; i < n; i++)
|
||||
flag[i + 1] = s >> i & 1;
|
||||
|
||||
// 多次调用dfs
|
||||
memset(st, 0, sizeof st);
|
||||
dfs(1);
|
||||
|
||||
int sum = 0;
|
||||
for (int i = 1; i <= n; i++) sum += f[1][i];
|
||||
if (__builtin_popcount(s) & 1) // 似乎是查询s里有多少个数字1
|
||||
ans -= sum;
|
||||
else
|
||||
ans += sum;
|
||||
}
|
||||
printf("%lld\n", ans);
|
||||
}
|
||||
64
TangDou/AcWing/DP/Tree/P3349.md
Normal file
64
TangDou/AcWing/DP/Tree/P3349.md
Normal file
@@ -0,0 +1,64 @@
|
||||
##[$P3349$ [$ZJOI2016$]小星星](https://www.luogu.com.cn/problem/P3349)
|
||||
|
||||
### 一、题目描述
|
||||
|
||||
小 Y 是一个心灵手巧的女孩子,她喜欢手工制作一些小饰品。她有 $n$ 颗小星星,用 $m$ 条彩色的细线串了起来,每条细线连着两颗小星星。
|
||||
|
||||
有一天她发现,她的饰品被破坏了,很多细线都被拆掉了。这个饰品只剩下了 $n-1$ 条细线,但通过这些细线,这颗小星星还是被串在一起,也就是这些小星星通过这些细线形成了树。小 Y 找到了这个饰品的设计图纸,她想知道现在饰品中的小星星对应着原来图纸上的哪些小星星。如果现在饰品中两颗小星星有细线相连,那么要求对应的小星星原来的图纸上也有细线相连。小 Y 想知道有多少种可能的对应方式。
|
||||
|
||||
只有你告诉了她正确的答案,她才会把小饰品做为礼物送给你呢。
|
||||
|
||||
#### 输入格式
|
||||
|
||||
第一行包含 $2$ 个正整数 $n,m$,表示原来的饰品中小星星的个数和细线的条数。
|
||||
|
||||
接下来 $m$ 行,每行包含 $2$ 个正整数 $u,v$,表示原来的饰品中小星星 $u$ 和 $v$ 通过细线连了起来。这里的小星星从 $1$ 开始标号。保证 $u\neq v$,且每对小星星之间最多只有一条细线相连。
|
||||
|
||||
接下来 $n-1$ 行,每行包含 $2$ 个正整数 $u,v$,表示现在的饰品中小星星 $u$ 和 $v$ 通过细线连了起来。保证这些小星星通过细线可以串在一起。
|
||||
|
||||
#### 输出格式
|
||||
|
||||
输出共 $1$ 行,包含一个整数表示可能的对应方式的数量。
|
||||
|
||||
如果不存在可行的对应方式则输出 `0`。
|
||||
|
||||
#### 样例 #1
|
||||
|
||||
#### 样例输入 #1
|
||||
|
||||
```
|
||||
4 3
|
||||
1 2
|
||||
1 3
|
||||
1 4
|
||||
4 1
|
||||
4 2
|
||||
4 3
|
||||
```
|
||||
|
||||
#### 样例输出 #1
|
||||
|
||||
```
|
||||
6
|
||||
```
|
||||
|
||||
#### 提示
|
||||
|
||||
对于 $100\%$ 的数据,$n\leq 17$,$m\leq \frac 12n(n-1)$。
|
||||
|
||||
### 二、解题思路
|
||||
**树形计数类$DP$+容斥**
|
||||
|
||||
**老套路** 设$f[x][u]$表示$x$子树中,$x$映射到原图中$u$这个点的方案数。
|
||||
|
||||
转移也很像,
|
||||
$$f[x][u]=\prod_{y\in x}\sum_{v\in u} f[y][u]*ma[u][v]$$
|
||||
|
||||
当前点集,总方案为$\displaystyle \sum_{i=1}^{n} f[root][i]$,即$root$映射到任意点的方案数之和。
|
||||
|
||||
意思是$x$对应$u$点,$y$对应$v$点,如果$u$和$v$相连,那么这一部分可以算为一种方案。
|
||||
容易发现状态是重复计算了的,所以要容斥一下。枚举点集的所有状态,记录点集大小,如果与$n$的差为偶则加,为奇则减。
|
||||
|
||||
这题很卡常,如果$T$了一定要参考代码实现。主要是要省掉统计点集大小这一步,建议用$dfs$来枚举所有状态。
|
||||
|
||||
https://www.cnblogs.com/bztMinamoto/p/9979627.html
|
||||
60
TangDou/AcWing/DP/Tree/P4084.cpp
Normal file
60
TangDou/AcWing/DP/Tree/P4084.cpp
Normal file
@@ -0,0 +1,60 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
typedef long long LL;
|
||||
const LL mod = 1e9 + 7;
|
||||
const int N = 1e5 + 10, M = N << 1;
|
||||
|
||||
int n, m;
|
||||
int color[N]; // 值域1~3
|
||||
|
||||
// 链式前向星
|
||||
int e[M], h[N], idx, ne[M];
|
||||
void add(int a, int b) {
|
||||
e[idx] = b, ne[idx] = h[a], h[a] = idx++;
|
||||
}
|
||||
|
||||
LL f[N][4]; // 设f[u][j]表示将u染色为j时,u这棵子树的方案数
|
||||
int st[N]; // 是不是访问过
|
||||
|
||||
void dfs(int u) {
|
||||
st[u] = 1; // 标识已访问
|
||||
// 初始化
|
||||
if (color[u])
|
||||
// 当某个节点被指定上色后,那么该节点另外两种颜色的方案数为0
|
||||
// 例如:当点u被指定上色2时:f[u][1]=0,f[u][3]=0 (因为无法上色1和3)
|
||||
f[u][color[u]] = 1;
|
||||
else
|
||||
f[u][1] = f[u][2] = f[u][3] = 1; // 三种颜色都可以染
|
||||
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
dfs(v);
|
||||
// 对于每个节点,因为不能于子节点上色相同
|
||||
f[u][1] = (f[u][1] * (f[v][2] + f[v][3]) % mod) % mod;
|
||||
f[u][2] = (f[u][2] * (f[v][1] + f[v][3]) % mod) % mod;
|
||||
f[u][3] = (f[u][3] * (f[v][1] + f[v][2]) % mod) % mod;
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
memset(h, -1, sizeof h);
|
||||
cin >> n >> m;
|
||||
|
||||
for (int i = 1; i < n; i++) {
|
||||
int a, b;
|
||||
cin >> a >> b;
|
||||
add(a, b), add(b, a);
|
||||
}
|
||||
|
||||
while (m--) {
|
||||
int u, c;
|
||||
cin >> u >> c;
|
||||
color[u] = c; // u节点被染过色,颜色为c
|
||||
}
|
||||
|
||||
dfs(1);
|
||||
|
||||
printf("%lld\n", (f[1][1] + f[1][2] + f[1][3]) % mod);
|
||||
return 0;
|
||||
}
|
||||
89
TangDou/AcWing/DP/Tree/P4084.md
Normal file
89
TangDou/AcWing/DP/Tree/P4084.md
Normal file
@@ -0,0 +1,89 @@
|
||||
##[$P4084$ $Barn$ $Painting$ $G$](https://www.luogu.com.cn/problem/P4084)
|
||||
|
||||
### 一、题目描述
|
||||
给定一颗$N$个节点组成的树,$3$种颜色,其中$K$个节点已染色,要求任意两相邻节点颜色不同,求合法染色方案数。
|
||||
|
||||
### 二、解题思路
|
||||
|
||||
树形计数类$DP$
|
||||
|
||||
**状态表示**
|
||||
设$f[u][j]$表示将$u$染色为$j$时,$u$这棵子树的方案数
|
||||
|
||||
**状态转移**
|
||||
$$\large f[u][j]=\prod_{v \in son[u]} \sum_{k \neq j}f[v][k]$$
|
||||
|
||||
**初始化**
|
||||
$f[u][j]=1$
|
||||
特别的,当$u$已被染色为$j$时,$f[u][k]=0(k!=t)$。
|
||||
|
||||
**答案**
|
||||
$\large f[1][0]+f[1][1]+f[1][2]$
|
||||
|
||||
**小结**
|
||||
树上$DP$求方案数的特点是对于$u$求出不包含$u$的子树方案,因为子树间互不相干,所以将$u$的子节点的子树 **所有方案之和** 乘起来就是 $u$子树的方案数 了。对于$u=root$,就是我们要求的总方案数。请注意其中加法原理和乘法原理的穿插运用。
|
||||
|
||||
|
||||
### 三、实现代码
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
typedef long long LL;
|
||||
const LL mod = 1e9 + 7;
|
||||
const int N = 1e5 + 10, M = N << 1;
|
||||
|
||||
int n, m;
|
||||
int color[N]; // 值域1~3
|
||||
|
||||
// 链式前向星
|
||||
int e[M], h[N], idx, ne[M];
|
||||
void add(int a, int b) {
|
||||
e[idx] = b, ne[idx] = h[a], h[a] = idx++;
|
||||
}
|
||||
|
||||
LL f[N][4]; // 设f[u][j]表示将u染色为j时,u这棵子树的方案数
|
||||
int st[N]; // 是不是访问过
|
||||
|
||||
void dfs(int u) {
|
||||
st[u] = 1; // 标识已访问
|
||||
// 初始化
|
||||
if (color[u])
|
||||
// 当某个节点被指定上色后,那么该节点另外两种颜色的方案数为0
|
||||
// 例如:当点u被指定上色2时:f[u][1]=0,f[u][3]=0 (因为无法上色1和3)
|
||||
f[u][color[u]] = 1;
|
||||
else
|
||||
f[u][1] = f[u][2] = f[u][3] = 1; // 三种颜色都可以染
|
||||
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
dfs(v);
|
||||
// 对于每个节点,因为不能于子节点上色相同
|
||||
f[u][1] = (f[u][1] * (f[v][2] + f[v][3]) % mod) % mod;
|
||||
f[u][2] = (f[u][2] * (f[v][1] + f[v][3]) % mod) % mod;
|
||||
f[u][3] = (f[u][3] * (f[v][1] + f[v][2]) % mod) % mod;
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
memset(h, -1, sizeof h);
|
||||
cin >> n >> m;
|
||||
|
||||
for (int i = 1; i < n; i++) {
|
||||
int a, b;
|
||||
cin >> a >> b;
|
||||
add(a, b), add(b, a);
|
||||
}
|
||||
|
||||
while (m--) {
|
||||
int u, c;
|
||||
cin >> u >> c;
|
||||
color[u] = c; // u节点被染过色,颜色为c
|
||||
}
|
||||
|
||||
dfs(1);
|
||||
|
||||
printf("%lld\n", (f[1][1] + f[1][2] + f[1][3]) % mod);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
17
TangDou/AcWing/DP/Tree/Test.cpp
Normal file
17
TangDou/AcWing/DP/Tree/Test.cpp
Normal file
@@ -0,0 +1,17 @@
|
||||
#include <iostream>
|
||||
using namespace std;
|
||||
|
||||
int main() {
|
||||
/*
|
||||
输入:
|
||||
1 (4) 5
|
||||
|
||||
期望:a=1,c=4,d=5
|
||||
*/
|
||||
char b;
|
||||
int a, c, d;
|
||||
cin >> a >> b >> c >> b >> d;
|
||||
cout << a << " " << c << " " << d << endl;
|
||||
cout << typeid(b).name() << endl;
|
||||
return 0;
|
||||
}
|
||||
160
TangDou/AcWing/DP/Tree/树形DP【专题】.md
Normal file
160
TangDou/AcWing/DP/Tree/树形DP【专题】.md
Normal file
@@ -0,0 +1,160 @@
|
||||
##树形$DP$专题
|
||||
|
||||
### 【$T1$】求一颗树的直径
|
||||
**难度 ★**
|
||||
**[$AcWing$ $1072$. 树的最长路径](https://www.cnblogs.com/littlehb/p/15784687.html)**
|
||||
|
||||
**难度 ★★**
|
||||
**[$AcWing$ $1073$. 树的中心](https://www.cnblogs.com/littlehb/p/15786805.html)**
|
||||
|
||||
**[$AcWing$ $1075$. 数字转换](https://www.cnblogs.com/littlehb/p/15787542.html)**
|
||||
|
||||
#### 法一:$dfs$来回两遍
|
||||
从任意一点出发找最长$A$,再从$A$找最长;和树形$DP$没有一丁点关系
|
||||
**缺点**:不能处理负权边
|
||||
```cpp {.line-numbers}
|
||||
void dfs1(int u, int sum) {
|
||||
st[u] = 1;
|
||||
if (sum > ans) {
|
||||
ans = sum; // 记录最大距离
|
||||
t1 = u; // 记录最远的点t1
|
||||
}
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int j = e[i];
|
||||
if (st[j]) continue;
|
||||
dfs1(j, sum + w[i]);
|
||||
}
|
||||
}
|
||||
|
||||
void dfs2(int u, int sum) {
|
||||
st[u] = 1;
|
||||
if (sum > ans) {
|
||||
ans = sum; // 记录最大距离
|
||||
t2 = u; // 记录最远的点t2
|
||||
}
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int j = e[i];
|
||||
if (st[j]) continue;
|
||||
dfs2(j, sum + w[i]);
|
||||
}
|
||||
}
|
||||
|
||||
...
|
||||
dfs1(1, 0); // 先找到点距离点1最远的点t
|
||||
...
|
||||
dfs2(t1, 0); // 找到距离点t最远的点
|
||||
```
|
||||
|
||||
|
||||
#### 法二:树形$DP$
|
||||
$d1[u]$表示到$u$的最长路径。$d2[u]$表示到$u$的第二长路径,那么易得 $d1[u]+ d2[u]$即为经过$u$的最长路径
|
||||
|
||||
```cpp {.line-numbers}
|
||||
void dfs(int u) {
|
||||
st[u] = 1;
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int j = e[i];
|
||||
if (st[j]) continue;
|
||||
// 走j子树
|
||||
dfs(j);
|
||||
|
||||
// d1[u]:最长路径,d2[u]:次长路径
|
||||
if (d1[j] + w[i] >= d1[u])
|
||||
d2[u] = d1[u], d1[u] = d1[j] + w[i]; // 最长路转移
|
||||
else if (d1[j] + w[i] > d2[u])
|
||||
d2[u] = d1[j] + w[i]; // 次长路转移
|
||||
}
|
||||
// 更新结果
|
||||
ans = max(ans, d1[u] + d2[u]);
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
###【$T2$】覆盖一棵树的最大、最小权值
|
||||
**难度 ★**
|
||||
**[$AcWing$ $323$ 战略游戏](https://www.cnblogs.com/littlehb/p/15788291.html)**
|
||||
|
||||
**难度★**
|
||||
**[$AcWing$ $285$. 没有上司的舞会](https://www.cnblogs.com/littlehb/p/15468981.html)**
|
||||
|
||||
**对比:**
|
||||
没有上司的舞会:每条边上 **最多** 选择一个点,**求最大权值**
|
||||
战略游戏:每条边上 **最少** 选择一条点,**求最小权值**
|
||||
|
||||
**难度★★★**
|
||||
**[$AcWing$ $1077$. 皇宫看守](https://www.cnblogs.com/littlehb/p/15788813.html)**
|
||||
|
||||
###【$T3$】保留一定数量的点、边,求方案数
|
||||
|
||||
**[$AcWing$ $1074$ . 二叉苹果树 ](https://www.cnblogs.com/littlehb/p/15788100.html)**
|
||||
|
||||
**[计蒜客 $Mila$的苹果树](https://www.jisuanke.com/problem/T3702)** 【**本质是就是二叉苹果树的变形**】
|
||||
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
typedef long long LL;
|
||||
|
||||
const int N = 2100, M = N << 1;
|
||||
const int MOD = 998244353;
|
||||
|
||||
int e[M], h[N], idx, ne[M];
|
||||
void add(int a, int b) {
|
||||
e[idx] = b, ne[idx] = h[a], h[a] = idx++;
|
||||
}
|
||||
|
||||
int n;
|
||||
int limit[N]; // 以u为根的子树中数量上限
|
||||
int st[N]; // 是不是访问过
|
||||
|
||||
LL f[N][N];
|
||||
|
||||
void dfs(int u) {
|
||||
st[u] = 1; // 访问过了
|
||||
f[u][0] = 1; // u子树中,放0个苹果的方案是1,此时只能是不管有多少个子结点,都是啥也不能放,方案唯一
|
||||
if (limit[u]) f[u][1] = 1; // 在u子树中,如果只放1个的话,那么必然是放在u节点上,否则u子树就不存在的,此时方案数是1
|
||||
|
||||
for (int i = h[u]; ~i; i = ne[i]) {
|
||||
int v = e[i];
|
||||
if (st[v]) continue;
|
||||
dfs(v);
|
||||
|
||||
// 分组背包
|
||||
for (int j = limit[u]; j >= 0; j--) // 枚举u子树体积,倒序降维
|
||||
// Q:为什么这里k=0开始是错的呢?
|
||||
for (int k = 1; k <= min(j, limit[v]); k++) // 枚举决策,v子树中放资源k个
|
||||
f[u][j] = (f[u][j] + f[v][k] * f[u][j - k]) % MOD;
|
||||
}
|
||||
}
|
||||
int main() {
|
||||
freopen("appletree.in", "r", stdin);
|
||||
freopen("appletree.out", "w", stdout);
|
||||
|
||||
memset(h, -1, sizeof h);
|
||||
|
||||
cin >> n;
|
||||
for (int i = 1; i <= n; i++) cin >> limit[i];
|
||||
|
||||
for (int i = 1; i < n; i++) {
|
||||
int a, b;
|
||||
cin >> a >> b;
|
||||
add(a, b), add(b, a); // 无向图
|
||||
}
|
||||
|
||||
dfs(1);
|
||||
|
||||
int res = 0;
|
||||
for (int i = 0; i <= limit[1]; i++) res = (res + f[1][i]) % MOD;
|
||||
|
||||
printf("%d\n", res);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
**[$51nod$ $1588$ 幸运树](https://www.cnblogs.com/littlehb/p/17203577.html)** 【树形$dp$统计树上方案数】
|
||||
|
||||
**[$P4084$ [$USACO17DEC$]$Barn$ $Painting$ $G$](https://www.cnblogs.com/littlehb/p/17204104.html)**
|
||||
|
||||
**[$P3349$ [$ZJOI2016$]小星星](https://www.luogu.com.cn/problem/P3349)** TODO
|
||||
|
||||
https://blog.csdn.net/A_Bright_CH/article/details/83443279
|
||||
172
TangDou/AcWing/DP/Tree/求约数和的三重境界.md
Normal file
172
TangDou/AcWing/DP/Tree/求约数和的三重境界.md
Normal file
@@ -0,0 +1,172 @@
|
||||
## 求约数和的三重境界
|
||||
|
||||
|
||||
### 一、先上结论
|
||||
|
||||
<!-- 让表格居中显示的风格 -->
|
||||
<style>
|
||||
.center
|
||||
{
|
||||
width: auto;
|
||||
display: table;
|
||||
margin-left: auto;
|
||||
margin-right: auto;
|
||||
}
|
||||
</style>
|
||||
<div class="center">
|
||||
|
||||
| 数据量/办法 | 暴力$O(N^2)$ | 普通筛法$O(N\cdot logN)$ | 欧拉筛法$O(N)$ |
|
||||
| ---- | ---- | ---- | ---- |
|
||||
| $n=1e5$ | $13402ms$ | $4ms$ | $2ms$ |
|
||||
| $n=1e6$ | 无法忍受,不能出结果 | $67ms$ | $15ms$ |
|
||||
|
||||
</div>
|
||||
|
||||
考虑到$O(N^2)$的复杂度,按$C++$一秒$1e8$的运算能力,$1e6*1e6=1e12$,应该是需要$1e12 /1e8=1e4=10000$秒,三个小时,去死吧!太垃圾了~
|
||||
|
||||
<font color='red' size=4><b>注意:
|
||||
* 普通筛法:代码极短,性能足够,推荐使用
|
||||
* 欧拉筛法:代码太长,性能优秀,不推荐使用
|
||||
|
||||
</b></font>
|
||||
|
||||
|
||||
### 二、暴力法
|
||||
|
||||
```c++
|
||||
//暴力大法 , 不包含自己
|
||||
int bforce(int n) {
|
||||
int sum = 0;
|
||||
for (int i = 1; i < n; i++) {
|
||||
if (n % i == 0)
|
||||
sum = sum + i;
|
||||
}
|
||||
return sum;
|
||||
}
|
||||
```
|
||||
时间复杂度$O(N^2)$
|
||||
|
||||
|
||||
### 三、普通筛法
|
||||
```c++
|
||||
for (int i = 1; i <= n; i++) // O(n)
|
||||
for (int j = 2; j <= n / i; j++) // 调和级数O(logn) = n + n / 2 + n / 3 + ... + n/n = lnn + c
|
||||
sum2[i * j] += i;
|
||||
```
|
||||
时间复杂度$O(N\cdot logN)$
|
||||
|
||||
### 四、线性筛法
|
||||
[原理解析](https://www.cnblogs.com/littlehb/p/16650121.html)
|
||||
|
||||
```c++
|
||||
int primes[N], cnt; // primes[]存储所有素数
|
||||
bool st[N]; // st[x]存储x是否被筛掉
|
||||
int num[N]; // i的最小质因子构成的一个等比数列求和的结果
|
||||
int sd[N]; //约数和
|
||||
void get_primes(int n) {
|
||||
sd[1] = 1; // 1的约数和是1
|
||||
|
||||
for (int i = 2; i <= n; i++) { //遍历 2~n,筛质数的同时,筛出每个数字的约数和
|
||||
if (!st[i]) { //如果i是质数
|
||||
primes[cnt++] = i; //记录i到质数数组中
|
||||
sd[i] = num[i] = 1 + i; //质数的约数和是1+自身
|
||||
}
|
||||
for (int j = 0; primes[j] * i <= n; j++) {
|
||||
st[i * primes[j]] = true; //记录primes[j]的整数倍(i倍)是合数
|
||||
|
||||
if (i % primes[j]) { //如果i不包含primes[j]这个质数因子
|
||||
sd[i * primes[j]] = sd[i] * sd[primes[j]];
|
||||
num[i * primes[j]] = primes[j] + 1;
|
||||
} else { //如果i包含了primes[j]这个质数因子
|
||||
sd[i * primes[j]] = sd[i] / num[i] * (num[i] * primes[j] + 1);
|
||||
num[i * primes[j]] = num[i] * primes[j] + 1;
|
||||
break;
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
### 五、附:测试对比的代码
|
||||
```c++
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
typedef long long LL;
|
||||
|
||||
const int N = 1e6 + 10;
|
||||
int sum1[N], sum2[N], sd[N];
|
||||
int n = 1e5;
|
||||
|
||||
//暴力大法 , 不包含自己
|
||||
int bforce(int n) {
|
||||
int sum = 0;
|
||||
for (int i = 1; i < n; i++) {
|
||||
if (n % i == 0)
|
||||
sum = sum + i;
|
||||
}
|
||||
return sum;
|
||||
}
|
||||
|
||||
int primes[N], cnt; // primes[]存储所有素数
|
||||
bool st[N]; // st[x]存储x是否被筛掉
|
||||
int num[N]; // i的最小质因子构成的一个等比数列求和的结果
|
||||
int sd[N]; //约数和
|
||||
void get_primes(int n) {
|
||||
sd[1] = 1; // 1的约数和是1
|
||||
|
||||
for (int i = 2; i <= n; i++) { //遍历 2~n,筛质数的同时,筛出每个数字的约数和
|
||||
if (!st[i]) { //如果i是质数
|
||||
primes[cnt++] = i; //记录i到质数数组中
|
||||
sd[i] = num[i] = 1 + i; //质数的约数和是1+自身
|
||||
}
|
||||
for (int j = 0; primes[j] * i <= n; j++) {
|
||||
st[i * primes[j]] = true; //记录primes[j]的整数倍(i倍)是合数
|
||||
|
||||
if (i % primes[j]) { //如果i不包含primes[j]这个质数因子
|
||||
sd[i * primes[j]] = sd[i] * sd[primes[j]];
|
||||
num[i * primes[j]] = primes[j] + 1;
|
||||
} else { //如果i包含了primes[j]这个质数因子
|
||||
sd[i * primes[j]] = sd[i] / num[i] * (num[i] * primes[j] + 1);
|
||||
num[i * primes[j]] = num[i] * primes[j] + 1;
|
||||
break;
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
//记录开始时间
|
||||
clock_t begin = clock();
|
||||
// 1、暴力计算 O(n^2)
|
||||
// for (int i = 1; i <= n; i++) sum1[i] = bforce(i);
|
||||
// for (int i = 1; i <= n; i++) printf("%d ", sum1[i]);
|
||||
puts("");
|
||||
//记录结束时间
|
||||
clock_t end = clock();
|
||||
cout << "Running time:" << (double)(end - begin) / CLOCKS_PER_SEC * 1000 << "ms" << endl;
|
||||
|
||||
// 2、通过筛法求出1到n的所有约数之和
|
||||
//记录开始时间
|
||||
begin = clock();
|
||||
for (int i = 1; i <= n; i++) // O(n)
|
||||
for (int j = 2; j <= n / i; j++) // 调和级数O(logn) = n + n / 2 + n / 3 + ... + n/n = lnn + c
|
||||
sum2[i * j] += i;
|
||||
|
||||
// for (int i = 1; i <= n; i++) printf("%d ", sum2[i]);
|
||||
puts("");
|
||||
//记录结束时间
|
||||
end = clock();
|
||||
cout << "Running time:" << (double)(end - begin) / CLOCKS_PER_SEC * 1000 << "ms" << endl;
|
||||
|
||||
// 3、利用欧拉定理筛出约数和
|
||||
//记录开始时间
|
||||
begin = clock();
|
||||
get_primes(n);
|
||||
// for (int i = 1; i <= n; i++) printf("%d ", sd[i]-i);
|
||||
puts("");
|
||||
//记录结束时间
|
||||
end = clock();
|
||||
cout << "Running time:" << (double)(end - begin) / CLOCKS_PER_SEC * 1000 << "ms" << endl;
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
257
TangDou/AcWing/DP/Tree/线性筛约数个数和与约数和.md
Normal file
257
TangDou/AcWing/DP/Tree/线性筛约数个数和与约数和.md
Normal file
@@ -0,0 +1,257 @@
|
||||
## 线性筛求 <font color='blue'>约数个数</font> 与 <font color='blue'>约数和</font>
|
||||
|
||||
线性筛,顾名思义,就是欧拉筛,在线性时间内可以求出答案,也就是$O(N)$的时间,非常牛$X$的效率。
|
||||
|
||||
### 一、约数个数
|
||||
|
||||
根据数字唯一分解定理,设
|
||||
$$\LARGE n=p_1^{r_1}*p_2^{r_2}*p_3^{r_3}*...*p_k^{r_k}$$
|
||||
|
||||
对于每个$n$的约数,一定是由以上质因数$p_1 \sim p_k$相乘而来,根据乘法原理,每个质因数都可以选择$0$到$r_i$这$r_i+1$个选择。
|
||||
|
||||
$n$的约数个数即为
|
||||
|
||||
$$\LARGE d(n)=(r_1+1)\times (r_2+1) \times ... \times (r_k+1) =\prod_{i=1}^k(r_i+1)$$
|
||||
|
||||
**筛的过程中需要保存$n$的最小质因子的出现个数即$r_1$,原因后面会说明:**
|
||||
|
||||
<font color='red' size=4><b>
|
||||
* $d[i]$记录$i$的约数个数
|
||||
* $num[i]$记录$i$的最小质因数个数
|
||||
|
||||
</b></font>
|
||||
|
||||
分情况讨论:
|
||||
|
||||
#### (一)、$i$是质数
|
||||
$$
|
||||
\large \left\{\begin{matrix}
|
||||
d[i]=2 & \\
|
||||
num[i]=1 &
|
||||
\end{matrix}\right.
|
||||
$$
|
||||
|
||||
* $d[i]$:$i$是质数,所以约数只有$1$和自身,约数个数为$2$
|
||||
* $num[i]$:$i$是质数,最小质因子就是自己,个数是$1$
|
||||
|
||||
#### (二)、$i$取模枚举的第$j$个质数为$0$, $primes[j]$整除$i$
|
||||
<font color='blue' size=4><b>$Q1:$我们在研究哪些数字之间的递推关系?</b></font>
|
||||
$A:$既然是递推,一般都是已知小的推出大的,这里应该是已知$d[i]$推出$d[i*primes[j]]$的值。
|
||||
|
||||
<font color='blue' size=4><b>$Q2$:$d[i*primes[j]]$是啥?</b></font>
|
||||
$A$: <font color='red' size=4><b>
|
||||
$primes[j]$是$i$的因子,$i*primes[j]$唯一分解不会产生新的质因子,依然是$p_1,p_2,...p_k$
|
||||
$primes[j]$从小到大枚举,所以一定是$i$的最小质因子!所以$p_1^{r_1+1}$,按唯一分解定理展开:
|
||||
|
||||
$$\large d[i*primes[j]]=(1+r_1+1)*......*(1+r_k)$$
|
||||
|
||||
</b></font>
|
||||
|
||||
<font color='blue' size=4><b>$Q3$:$d[i∗primes[j]]$怎么从$d[i]$转移?</b></font>
|
||||
|
||||
这个时候就可以用到我们之前维护的$num[i]$了。
|
||||
|
||||
转移也就非常简单了:
|
||||
|
||||
$$\large d[i∗primes[j]]=d[i]/(num[i]+1)∗(num[i]+2)$$
|
||||
|
||||
<font color='red' size=4><b>解释:
|
||||
|
||||
$$
|
||||
\large \left\{\begin{matrix}
|
||||
d(i)=(1+r_1)*......*(1+r_k) & ①\\
|
||||
d(i*primes[j])=(1+r_1+1)*......*(1+r_k) & ②\\
|
||||
\end{matrix}\right.
|
||||
$$
|
||||
|
||||
使用瞪眼大法(观察法),找出两者之间的递推关系,很明显,就是 ①式除以$1+r_1$,再乘上$1+r_1+1$即可转化为 ②式,这下明白为什么要记录$num[i]$最小质因子的个数了吧~
|
||||
</b></font>
|
||||
|
||||
<font color='blue' size=4><b>$Q4$:那么$num[i∗primes[j]]$是不是也需要从$num[i]$进行转移呢?</b></font>
|
||||
$A$:$num[i*primes[j]]$也要转移,加上最小质因子$primes[j]$的贡献也就是:
|
||||
|
||||
$$\large num[i∗primes[j]]=num[i]+1$$
|
||||
|
||||
|
||||
|
||||
#### (三)、当前数取模枚举的第$j$个质数不为$0$,即 $primes[j]$ 不能整除 $i$
|
||||
|
||||
首先我们知道$i∗primes[j]$这个数中之前一定不包含$primes[j]$这个质因数,
|
||||
|
||||
那么约数个数要加上$prime[j]$的,也就是:
|
||||
|
||||
$$\large d[i*primes[j]]=(1+r_1)*...*(1+r_k)*(1+1) \\
|
||||
=d[i]*2=d[i]*d[primes[j]] $$
|
||||
|
||||
|
||||
然后对于最小质因子,因为$j$是从小到大枚举的,所以$i∗primes[j]$这个数的最小质因子也就是$primes[j]$
|
||||
|
||||
所以就可以得到:
|
||||
|
||||
$$\large num[i*primes[j]]=1$$
|
||||
|
||||
综上,就可以写出筛质因数个数的代码了:
|
||||
|
||||
```c++
|
||||
#include <iostream>
|
||||
#include <cstdio>
|
||||
#include <cstring>
|
||||
using namespace std;
|
||||
const int N = 1010;
|
||||
|
||||
int primes[N], cnt; // primes[]存储所有素数
|
||||
bool st[N]; // st[x]存储x是否被筛掉
|
||||
int d[N]; // d[x]表示x的约数个数
|
||||
int num[N]; // num[x]表示x的最小质因数的个数
|
||||
int n;
|
||||
|
||||
//欧拉筛法+求约数个数
|
||||
void get_primes(int n) {
|
||||
d[1] = 1; // 1的约数只有1个,这个比较特殊
|
||||
|
||||
for (int i = 2; i <= n; i++) {
|
||||
if (!st[i]) {
|
||||
primes[cnt++] = i;
|
||||
// i是质数
|
||||
d[i] = 2; //约数个数是2个,一个是1,另一个是i
|
||||
num[i] = 1; //最小质因子个数是1,最小质因子就是自己i
|
||||
}
|
||||
|
||||
for (int j = 0; i * primes[j] <= n; j++) {
|
||||
st[i * primes[j]] = true;
|
||||
if (i % primes[j] == 0) {
|
||||
d[i * primes[j]] = d[i] / (num[i] + 1) * (num[i] + 2);
|
||||
num[i * primes[j]] = num[i] + 1;
|
||||
break;
|
||||
} else {
|
||||
// d[i * primes[j]] = d[i] * d[primes[j]]; 等价于下面的代码
|
||||
d[i * primes[j]] = d[i] * 2;
|
||||
num[i * primes[j]] = 1;
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
scanf("%d", &n);
|
||||
get_primes(n);
|
||||
//输出1~n之间所有数字的约数个数
|
||||
for (int i = 1; i <= n; i++) printf("%d %d\n", i, d[i]);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
### 二、约数和
|
||||
|
||||
<font color='red' size=4><b>设$sd[i]$表示$i$的约数和</b></font>
|
||||
|
||||
根据算数基本定理得:[约数和参考链接](https://www.cnblogs.com/littlehb/p/15341428.html)
|
||||
|
||||
$$\large sd[n]=(p_1^0+p_1^1+p_1^2+……+p_1^{r_1})∗(p_2^0+p_2^1+p_2^2+……+p_2^{r_2})∗……∗(p_k^0+p_k^1+p_k^2+……+p_k^{r_k})$$
|
||||
|
||||
那么根据这个式子就可以开始干了。。。
|
||||
|
||||
<font color='red' size=4><b>
|
||||
设$num[i]$表示最小质因子的那一项:
|
||||
$$\large num[i]= p_1^0+p_1^1+p_1^2+……+p_1^{r_1}$$
|
||||
</b></font>
|
||||
|
||||
|
||||
分情况讨论:
|
||||
|
||||
#### (一)、$i$是质数
|
||||
$$\large sd[i]=num[i]=i+1$$
|
||||
<font color='red' size=4><b>解释:
|
||||
* $i$是质数,它的约数只有自己和$1$,约数和是$i+1$
|
||||
* $i$是质数,质因子分解也只能分解出自己,$sd[i]=i^0+i^1=1+i$
|
||||
|
||||
</b></font>
|
||||
|
||||
|
||||
#### (二)、$i$取模枚举的质数$primes[j]$不为0,即$primes[j]$不能整除$i$
|
||||
<font color='red' size=4><b>注:下面的讨论中使用$p_j$代替$primes[j]$</b></font>
|
||||
|
||||
$i∗p_j$里原先没有$p_j$这一项,加上这一项之后:
|
||||
|
||||
$$\large \because sd[i]=(p_1^0+p_1^1+p_1^2+……+p_1^{r_1})∗(p_2^0+p_2^1+p_2^2+……+p_2^{r_2})∗……∗(p_k^0+p_k^1+p_k^2+……+p_k^{r_k})$$
|
||||
|
||||
$$\large \because sd[i*p_j]=(p_1^0+p_1^1+p_1^2+……+p_1^{r_1})∗(p_2^0+p_2^1+p_2^2+……+p_2^{r_2})∗……∗(p_k^0+p_k^1+p_k^2+……+p_k^{r_k})*(p_j^0+p_j^1)$$
|
||||
|
||||
$\large \because p_j$ 是质数 $\large \therefore sd[p_j]=p_j^0+p_j^1$
|
||||
|
||||
$\large \therefore sd[i*p_j]=sd[i]*sd[p_j]$ <font color='red' size=4><b>注:积性函数</b></font>
|
||||
|
||||
|
||||
**同时更新一下$num[i∗p_j]$**
|
||||
|
||||
$$\large num[i∗p_j]=num[p_j]=p_j^0+p_j^1=1+p_j$$
|
||||
|
||||
<font color='red' size=4><b>解释:
|
||||
因为质因子从小到大枚举,那么$i∗p_j$的最小质因子就应该是$p_j$,那么$num[i∗p_j]$也就应该等于$num[p_j]$
|
||||
</b></font>
|
||||
|
||||
#### (三)、$i$取模枚举的质数$j$为0,即 $primes[j]$整除$i$
|
||||
|
||||
那么$sd[i∗p_j]$中的第一项也就是$num[i∗p_j]$也一定是$p_j$的第一项
|
||||
|
||||
<font color='red' size=4><b>解释:(等比数列变形小技巧)</b></font>
|
||||
$1+p_i+p_i^2+……+p_i^{r_i}$这个时候要变成$1+p_i+p_i^2+……+p_i^{r_i}+p_i^{r_i+1}$,那么只需要所有的都乘以一个$p_i$,然后再加一个$1$就好了。
|
||||
<font color='red' size=4><b>
|
||||
$$\large (1+p_i+p_i^2+……+p_i^{r_i})*p_i+1= \\
|
||||
1+p_i+p_i^2+……+p_i^{r_i}+p_i^{r_i+1}$$
|
||||
</b></font>
|
||||
|
||||
**结论:**
|
||||
|
||||
$$\large num[i∗p_j]=num[i]∗p_j+1$$
|
||||
|
||||
这样,我们又可以开始愉快的写代码啦...
|
||||
|
||||
```c++
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
typedef long long LL;
|
||||
|
||||
const int N = 1e3 + 10;
|
||||
|
||||
int primes[N], cnt;
|
||||
bool st[N];
|
||||
|
||||
int num[N]; //最小质因子p1组成的等比序列 p1^0+p1^1+...+p1^r1
|
||||
int sd[N]; //约数和
|
||||
|
||||
int n;
|
||||
|
||||
void get_primes(int n) {
|
||||
sd[1] = 1; // 1的约数只有自己,约数和是1
|
||||
|
||||
for (int i = 2; i <= n; i++) {
|
||||
if (!st[i]) {
|
||||
primes[cnt++] = i;
|
||||
//质数
|
||||
sd[i] = num[i] = i + 1; // 1和自身是约数,约数和为i+1; 同时因为i是质数,所以只有一个分拆项,并且分拆项内容=pj^0+pj^1=1+pj=1+i
|
||||
}
|
||||
for (int j = 0; primes[j] * i <= n; j++) {
|
||||
st[i * primes[j]] = true;
|
||||
|
||||
if (i % primes[j]) {
|
||||
sd[i * primes[j]] = sd[i] * sd[primes[j]]; //积性函数
|
||||
num[i * primes[j]] = primes[j] + 1;
|
||||
} else {
|
||||
sd[i * primes[j]] = sd[i] / num[i] * (num[i] * primes[j] + 1);
|
||||
num[i * primes[j]] = num[i] * primes[j] + 1;
|
||||
break;
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
|
||||
int main() {
|
||||
scanf("%d", &n);
|
||||
get_primes(n);
|
||||
//约数和要不要自己本身,这里是不想要自己本身
|
||||
for (int i = 1; i <= n; i++) printf("%d ", sd[i] - i);
|
||||
puts("");
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
Reference in New Issue
Block a user