'commit'
This commit is contained in:
 HuangHai
50
TangDou/AcWing/Trie/143.cpp
Normal file
50
TangDou/AcWing/Trie/143.cpp
Normal file
@@ -0,0 +1,50 @@
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
|
||||
const int N = 1e5 + 10;
|
||||
const int M = N * 31;
|
||||
|
||||
int n, res;
|
||||
int a[N];
|
||||
int tr[M][2];
|
||||
int idx;
|
||||
|
||||
// 构建数字二进制位的Trie树
|
||||
void insert(int x) {
|
||||
int p = 0;
|
||||
for (int i = 30; i >= 0; i--) {
|
||||
int u = (x >> i) & 1; // 取出当前位的值
|
||||
if (!tr[p][u]) tr[p][u] = ++idx; // 构建Trie树
|
||||
p = tr[p][u];
|
||||
}
|
||||
}
|
||||
|
||||
// 所谓与x异或最大,就是利求在高位上尽量不一样,如果找不到不一样的,就只能找一样的,下一个继续优先找不一样的
|
||||
// 在Trie树中查找到与x异或最大的数
|
||||
int query(int x) {
|
||||
int p = 0, ans = 0;
|
||||
for (int i = 30; i >= 0; i--) {
|
||||
int u = (x >> i) & 1; // 取出x的当前二进制位
|
||||
if (tr[p][!u]) { // 如果存在可以异或的路可以走的话,尽量先走
|
||||
p = tr[p][!u];
|
||||
ans = ans * 2 + !u; // 还原二进制数字为十进制
|
||||
} else {
|
||||
p = tr[p][u]; // 否则只能走与自己本位一样的路线
|
||||
ans = ans * 2 + u; // 还原二进制数字为十进制
|
||||
}
|
||||
}
|
||||
return ans;
|
||||
}
|
||||
|
||||
int main() {
|
||||
cin >> n;
|
||||
for (int i = 1; i <= n; i++) cin >> a[i], insert(a[i]);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int t = query(a[i]);
|
||||
res = max(res, a[i] ^ t);
|
||||
}
|
||||
printf("%d", res);
|
||||
return 0;
|
||||
}
|
||||
132
TangDou/AcWing/Trie/143.md
Normal file
132
TangDou/AcWing/Trie/143.md
Normal file
@@ -0,0 +1,132 @@
|
||||
##[$AcWing$ $143$. 最大异或对](https://www.acwing.com/problem/content/145/)
|
||||
|
||||
### 一、题目描述
|
||||
在给定的 $N$ 个整数 $A_1,A_2……A_N$ 中选出两个进行 $xor$(异或)运算,得到的结果最大是多少?
|
||||
|
||||
**输入格式**
|
||||
第一行输入一个整数 $N$。
|
||||
|
||||
第二行输入 $N$ 个整数 $A_1~A_N$。
|
||||
|
||||
**输出格式**
|
||||
输出一个整数表示答案。
|
||||
|
||||
**数据范围**
|
||||
$1≤N≤10^5,0≤Ai<2^{31}$
|
||||
|
||||
**输入样例:**
|
||||
```cpp {.line-numbers}
|
||||
3
|
||||
1 2 3
|
||||
```
|
||||
**输出样例:**
|
||||
```cpp {.line-numbers}
|
||||
3
|
||||
```
|
||||
|
||||
### 二、分析思路
|
||||
先来思考暴力怎么做:
|
||||
``` c++
|
||||
// 最大异或对,用暴力是超时的
|
||||
// 通过了 6/10个数据
|
||||
#include<iostream>
|
||||
using namespace std;
|
||||
const int N=1e5+10;
|
||||
int a[N];
|
||||
int res;
|
||||
int main(){
|
||||
int n;
|
||||
cin>>n;
|
||||
for(int i=1;i<=n;i++) cin>>a[i];
|
||||
|
||||
for(int i=1;i<=n;i++)
|
||||
for(int j=i+1;j<=n;j++)
|
||||
res=max(res,a[i]^a[j]);
|
||||
cout<<res<<endl;
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
结果不出意外,$TLE$,只能想办法进行优化
|
||||
|
||||
#### $Trie$树思路
|
||||
|
||||
1、将整数解析为二进制数,即有符号整数,$31$位,就是$0-30$,按$Trie$树进行存储, **整数的$Trie$树存储**。
|
||||
|
||||
2、每个数字的每一个二进制位,需要从高位到低位,即`for(int i = 30; i >= 0; i--)`,想像一下你在构建一个$Trie$树,那么根$root$就是最高位,然后一路走到$31$位,就是最低位。
|
||||
|
||||
3、每个数字想要找到与自己形成最大异或值的另一个数字,我们现在已经把它们保存到$Trie$树里了,那怎么找呢?什么样的两个数字才是最大异或值的对呢?就是每一位完全相反的就肯定是最大的异或对!那如果某一位相反的结点并不存在呢?这就是退而求其次的思路了,我们尽量从左到右找出与当前数字本位相反的路径,如果存在,就继续探索,如果不存在,那就使用一样的本位值。这样下来,到$31$位,就可以找到和自己匹配最大的异或值。
|
||||
|
||||
#### 总结一下
|
||||
- $Trie$里可以用来保存数字,数字需要通过二进制(由高位到低位)进行保存。
|
||||
|
||||
- 增加一个数字进来,其实就是增加了一个层级为$31$级的 **模拟字符串**
|
||||
|
||||
- 放入一个数字,那么它肯定会在任意一级(共$31$级)存在一边,另一边可能存在,也可能不存在。
|
||||
|
||||
|
||||
### 三、实现代码
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
|
||||
const int N = 1e5 + 10;
|
||||
const int M = N * 31;
|
||||
|
||||
int n, res;
|
||||
int a[N];
|
||||
int tr[M][2];
|
||||
int idx;
|
||||
|
||||
// 构建数字二进制位的Trie树
|
||||
void insert(int x) {
|
||||
int p = 0;
|
||||
for (int i = 30; i >= 0; i--) {
|
||||
int u = (x >> i) & 1; // 取出当前位的值
|
||||
if (!tr[p][u]) tr[p][u] = ++idx; // 构建Trie树
|
||||
p = tr[p][u];
|
||||
}
|
||||
}
|
||||
|
||||
// 所谓与x异或最大,就是利求在高位上尽量不一样,如果找不到不一样的,就只能找一样的,下一个继续优先找不一样的
|
||||
// 在Trie树中查找到与x异或最大的数
|
||||
int query(int x) {
|
||||
int p = 0, ans = 0;
|
||||
for (int i = 30; i >= 0; i--) {
|
||||
int u = (x >> i) & 1; // 取出x的当前二进制位
|
||||
if (tr[p][!u]) { // 如果存在可以异或的路可以走的话,尽量先走
|
||||
p = tr[p][!u];
|
||||
ans = ans * 2 + !u; // 还原二进制数字为十进制
|
||||
} else {
|
||||
p = tr[p][u]; // 否则只能走与自己本位一样的路线
|
||||
ans = ans * 2 + u; // 还原二进制数字为十进制
|
||||
}
|
||||
}
|
||||
return ans;
|
||||
}
|
||||
|
||||
int main() {
|
||||
cin >> n;
|
||||
for (int i = 1; i <= n; i++) cin >> a[i], insert(a[i]);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int t = query(a[i]);
|
||||
res = max(res, a[i] ^ t);
|
||||
}
|
||||
printf("%d", res);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
### 五、对于一维数据范围的思考
|
||||
无论是模板题还是最大异或对着一题
|
||||
都有这么一行代码
|
||||
`if (!tr[p][u]) tr[p][u] = ++ idx; p = tr[p][u];`
|
||||
|
||||
所以我们可以知道,$tr$数组的一维下标最大值的选取实际上是跟$idx$能够自增多少次来决定的
|
||||
|
||||
**[$AcWing$ $835$. $Trie$字符串统计](https://www.acwing.com/problem/content/837/)** 中,输入的字符串总长度不超过 $10^5$,所以一维值选取$1e5+10$
|
||||
|
||||
|
||||
而在 **[$AcWing$ $143$. 最大异或对](https://www.acwing.com/problem/content/description/145/)** 中,数字需要以$2$进制进行表示,而每个数字最大为$2$的$31$次幂,所以一维下标应为数字的个数*$31$。
|
||||
|
||||
70
TangDou/AcWing/Trie/256.cpp
Normal file
70
TangDou/AcWing/Trie/256.cpp
Normal file
@@ -0,0 +1,70 @@
|
||||
#include <cstdio>
|
||||
#include <cstring>
|
||||
#include <algorithm>
|
||||
#include <iostream>
|
||||
#include <cmath>
|
||||
|
||||
using namespace std;
|
||||
|
||||
const int N = 6e5 + 10, M = 25 * N;
|
||||
int s[N];
|
||||
int tr[M][2], ver[M];
|
||||
int root[N], idx;
|
||||
|
||||
void insert(int k, int p, int q) {
|
||||
for (int i = 23; ~i; i--) {
|
||||
int u = s[k] >> i & 1;
|
||||
tr[q][u ^ 1] = tr[p][u ^ 1]; //复制
|
||||
tr[q][u] = ++idx; //创建
|
||||
ver[tr[q][u]] = k; //记录版本
|
||||
q = tr[q][u], p = tr[p][u];
|
||||
}
|
||||
}
|
||||
|
||||
int query(int p, int l, int c) {
|
||||
for (int i = 23; ~i ; i--) {
|
||||
int u = c >> i & 1;
|
||||
if (tr[p][u ^ 1] && ver[tr[p][u ^ 1]] >= l)
|
||||
p = tr[p][u ^ 1];
|
||||
else
|
||||
p = tr[p][u];
|
||||
}
|
||||
return c ^ s[ver[p]]; // p:最终停留在的异或和最大值终点处,ver[p]这是哪个版本放进来的?,s[ver[p]]=S_{p-1}
|
||||
}
|
||||
|
||||
int main() {
|
||||
ios::sync_with_stdio(false), cin.tie(0);
|
||||
int n, m;
|
||||
cin >> n >> m;
|
||||
|
||||
// 0号版本,用于处理类似于S[1]-S[0]这样的递推边界值
|
||||
root[0] = ++idx;
|
||||
insert(0, 0, root[0]);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int x;
|
||||
cin >> x;
|
||||
root[i] = ++idx;
|
||||
s[i] = s[i - 1] ^ x; //原数组不重要,异或前缀和数组才重要
|
||||
insert(i, root[i - 1], root[i]);
|
||||
}
|
||||
|
||||
while (m--) {
|
||||
char op;
|
||||
cin >> op;
|
||||
if (op == 'A') {
|
||||
int x;
|
||||
cin >> x;
|
||||
n++;
|
||||
|
||||
root[n] = ++idx;
|
||||
s[n] = s[n - 1] ^ x;
|
||||
insert(n, root[n - 1], root[n]);
|
||||
} else {
|
||||
int l, r, x;
|
||||
cin >> l >> r >> x;
|
||||
printf("%d\n", query(root[r - 1], l - 1, s[n] ^ x));
|
||||
}
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
197
TangDou/AcWing/Trie/256.md
Normal file
197
TangDou/AcWing/Trie/256.md
Normal file
@@ -0,0 +1,197 @@
|
||||
##[$AcWing$ $256$. 最大异或和](https://www.acwing.com/problem/content/258/)
|
||||
|
||||
### 一、题目大意
|
||||
给定一个非负整数序列 $a$,初始长度为 $N$。
|
||||
|
||||
有 $M$ 个操作,有以下两种操作类型:
|
||||
|
||||
`A x`:添加操作,表示在序列末尾添加一个数 $x$,序列的长度 $N$ 增大 $1$。
|
||||
`Q l r x`:询问操作,你需要找到一个位置 $p$,满足 $l≤p≤r$,使得:$a[p]⊕ a[p+1]⊕ … ⊕a[N]⊕ x$ 最大,输出这个**最大值**
|
||||
|
||||
**输入格式**
|
||||
第一行包含两个整数 $N,M$,含义如问题描述所示。
|
||||
|
||||
第二行包含 $N$ 个 **非负整数**,表示初始的序列 $A$。
|
||||
|
||||
接下来 $M$ 行,每行描述一个操作,格式如题面所述。
|
||||
|
||||
**输出格式**
|
||||
每个询问操作输出一个整数,表示询问的答案。
|
||||
|
||||
每个答案占一行。
|
||||
|
||||
**数据范围**
|
||||
$N,M≤3×10^5,0≤a[i]≤10^7$。
|
||||
|
||||
**输入样例:**
|
||||
```cpp {.line-numbers}
|
||||
5 5
|
||||
2 6 4 3 6
|
||||
A 1
|
||||
Q 3 5 4
|
||||
A 4
|
||||
Q 5 7 0
|
||||
Q 3 6 6
|
||||
```
|
||||
**输出样例:**
|
||||
```cpp {.line-numbers}
|
||||
4
|
||||
5
|
||||
6
|
||||
```
|
||||
### 二、前导知识
|
||||
|
||||
#### 异或问题
|
||||
异或问题是研究数列上异或性质的一类问题,例如 **区间最大异或**,**异或和** 相关问题等,解决这些问题通常用到下面的几个性质:
|
||||
|
||||
* 交换律 $a\oplus b = b \oplus a$
|
||||
* 结合律 $(a\oplus b)\oplus c =a\oplus (b\oplus c)$
|
||||
* 自反性 $x \oplus x =0$
|
||||
* 或 0 不变性 $x \oplus 0 =x$
|
||||
|
||||
根据自反性质,区间的异或值**具有前缀和性质**,即
|
||||
$$\bigoplus _{i=l}^{r}a_i= \left (\bigoplus _{i=1}^{l-1} a_i \right ) \bigoplus \left (\bigoplus _{i=1}^{r} a_i \right )$$
|
||||
|
||||
因此我们可以更方便地处理问题。
|
||||
|
||||
**证明**:
|
||||
设$S(x)=a_1 \oplus a_2 \oplus ... \oplus a_x$
|
||||
|
||||
$$\large S(r)=a_1 \oplus a_2 \oplus ... \oplus a_r \\
|
||||
S(l-1)=a_1 \oplus a_2 \oplus ... \oplus a_{l-1} \\
|
||||
S(r) \oplus S(l-1) = a_l \oplus a_{l+1} ... \oplus a_r$$
|
||||
|
||||
|
||||
|
||||
#### 可持久化$Trie$
|
||||
|
||||
**$Q$:本题涉及到的是异或运算和,使用$Tire$树是可以理解的,但为什么一定要持久化,不持久化为什么不行?**
|
||||
|
||||
$A$: 之所以选择可持久化$Trie$来完成这道题,原因是:
|
||||
* 普通最大异或值可以通过构建普通$Trie$,一路能反着走就反着走,实在走不了就正着走,来获取,这是一个贪心的思想
|
||||
* 普通$Trie$无法解决区间$[L,R]$这样的查询问题,一查就是全套的,不知道什么进候收手
|
||||
* 如果记录并枚举从$L$~$R$的每一个$Trie$树,就在空间和时间上过不去,这时,**持久化$Trie$树登场**
|
||||
* $[1\sim R-1]$可以直接查找版本号为$R-1$的数据,不会取到大于等于$R-1$的数据
|
||||
* $[L-1 \sim R-1]$的数据,其实在版本为$R-1$的树中其实都存在的,但直接取怕到$[1\sim L-2]$中去,造成错误查询, 办法就是在每个节点创建时,标识它是由哪个版本创建的,如果是$>=L-1$的,才能访问
|
||||
|
||||
|
||||
**可持久化**:下面介绍 $Trie$ 是如何实现可持久化的。
|
||||
|
||||
既然我们现在要访问一个历史版本,那么我们直观的想法就是将每一个版本的 $Trie$ 结构体都存储下来,当需要一个新的结点时,我们完全复制一个历史版本,然后再它上面完成操作。这样的做法,正确性是显然的,但是空间开销却让人头疼。当务之急是减少存储空间,我们考虑将 $Trie$ 树上的一些 **枝条** 共用来减少空间上的浪费。
|
||||
|
||||
这样做:对于一个新建的版本,每插入一个点都新建一个节点,然后完全复制历史版本上同等地位点的全部儿子信息,可以看下面这张图来方便你的理解。
|
||||
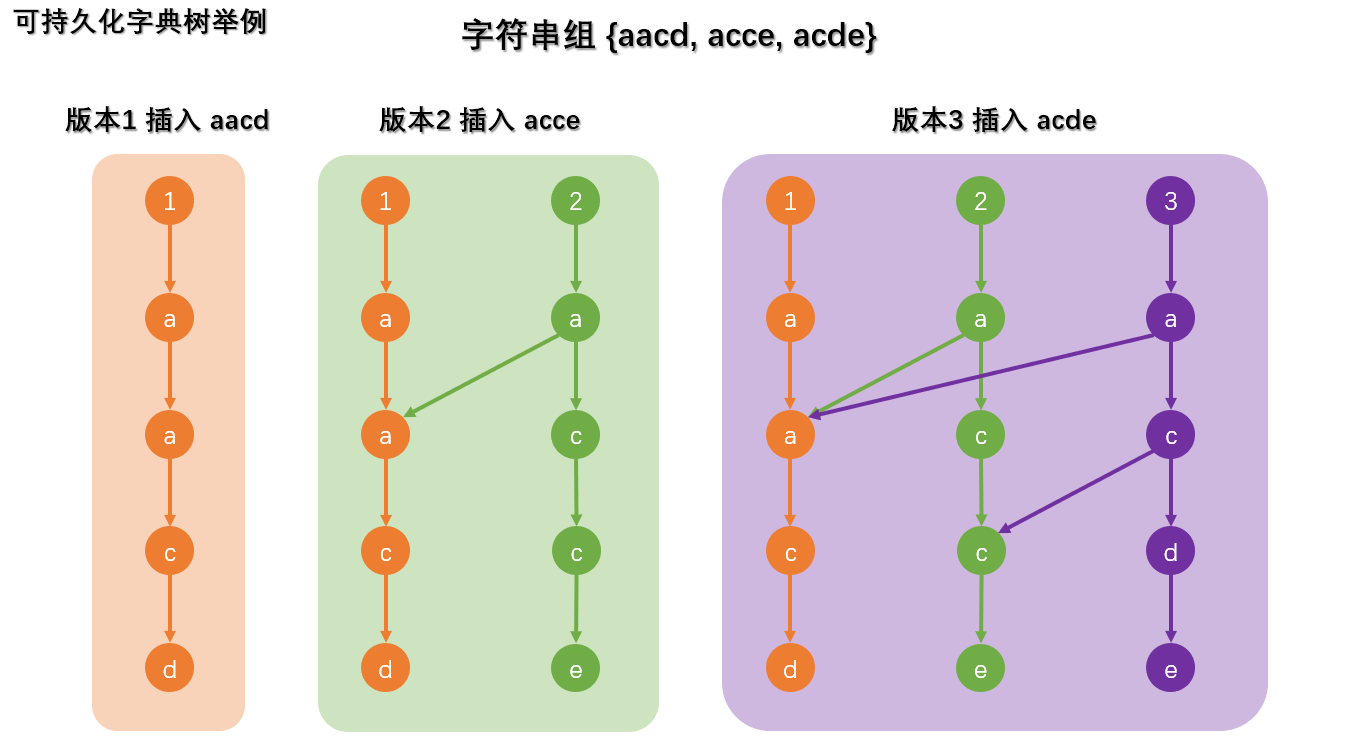
|
||||
|
||||
通过上图我们发现,从一个版本起点开始,遍历整棵树,一定只能获得该版本内的所有串,并且空间大大减少,是不是非常优美。
|
||||
|
||||
对于区间 $[l,r]$上的一些询问,我们转化为对版本$l − 1$和$r$之间插值的询问。这样就可以通过可持久化的方法来求解区间信息。
|
||||
|
||||
#### 图集
|
||||
##### 1. $Trie$树中保存的是什么?
|
||||
<center><img src='https://cdn.acwing.com/media/article/image/2021/03/12/69550_198b4f3983-%E5%8F%AF%E6%8C%81%E4%B9%85%E5%8C%96trie%E6%A0%91.png'></center>
|
||||
|
||||
##### 2. 可持久化$Trie$的构建步骤
|
||||
<center><img src='https://cdn.acwing.com/media/article/image/2021/04/24/8330_69574ea4a4-trie.001.jpeg'></center>
|
||||
|
||||
|
||||
### 四、本题思路
|
||||
定义$S_i$表示前$i$个数的 **异或前缀和**,即:
|
||||
$$S_0=0 \ S_1=a_1\ S_2=a_1⨁a_2 \ … \ S_i=a_1⨁a_2⨁a_3......⨁a_i$$
|
||||
|
||||
需要求解的内容变为:
|
||||
$$a_p⨁......⨁a_n⨁x=S_{p−1}⨁S_n⨁x$$
|
||||
|
||||
上面的式子中可以将$S_n⨁x$看成常数,记为$C$,则相当于在区间$[L,R]$中找到一个位置$p$,使得$S_{p−1}⨁C$的值 **最大**
|
||||
|
||||
类似于[$AcWing$ $143$. 最大异或对](https://blog.csdn.net/weixin_42638946/article/details/115554023?spm=1001.2014.3001.5502)
|
||||
|
||||
将每个数据$a_i$看成一个 **二进制字符串,存入到$Trie$中**。因为$0≤a[i]≤10^7$,又$2^{23}≤a[i]≤2^{24}$,因此我们需要将每个数据对应到一个长度为$24$为的$01$二进制串上。
|
||||
|
||||
<font color='red'><b>先考虑简单情况</b></font>
|
||||
假设让我们从$[1,R]$中找到一个这样的$p$的话,问题就十分类似于[$AcWing$ $143$. 最大异或对](https://blog.csdn.net/weixin_42638946/article/details/115554023?spm=1001.2014.3001.5502),**不同点** 在于本题中的$a$数组是<font color='red'><b>不断变化的</b></font>,维护一个$Trie$树,只能计算某个时刻问题。
|
||||
|
||||
|
||||
因此要**记录下所有历史版本的$Trie$树**,$root[R]$中存储的就是插入$a[1\sim R]$时形成的$Trie$树。
|
||||
|
||||
#### 小结
|
||||
* 利用可持久化的$Trie$树这种数据结构,可以实现从$1\sim R$区间查询。,其中$R$也就是版本号,也就是第$R$个插入的字符串。
|
||||
|
||||
* 如果区间左边的限制也加上,则问题就变成了让我们在区间$[L,R]$中找到一个$p$,使得$S_{p−1}⨁C$的值最大,可以这样处理:在$trie$树中的每个节点中多记录一个信息$ver$,**表示第几个版本插入的,也就是第几个数时插入的**,如果$ver[u]≥L$,则说明这棵子树在$[L,R]$这个区间中存在。
|
||||
|
||||
* 对于上面提到的某个$C$,数据$A$可以看成一个$24$位长度的二进制字符串,从左到右遍历这个字符串,假设当前考察的是字符$t$,则在$trie$树中我们应该走到`t ^ 1`的分支上(如果存在的话,即对于区间$[L,R]$,如果该分支对应的$ver[u]≥L$,则说明存在),这样异或值才能最大(贪心思想)
|
||||
|
||||
* 原序列长度为$3×10^5$,因为操作的个数最多也是$3×10^5$,因此序列的长度最大是$6×10^5$。另外还需要考虑$trie$中节点的个数:每次操作最多建立$24$个节点,再加上根节点,一共$25$个节点,每个数据最多建立$25$个节点,因此节点数为$25×6×10^5=1.5×10^7$,每个节点两个分支,因此第二维为$2$;另外还需要记录每个点的$ver$,需要的空间量是$1.5×10^7×3=4.5×10^7$个$int$,大约$4.5×10^7×4/10^6=180MB$的存储空间,题目提供$256MB$的存储空间,满足要求
|
||||
|
||||
### 五、实现代码
|
||||
```cpp {.line-numbers}
|
||||
#include <cstdio>
|
||||
#include <cstring>
|
||||
#include <algorithm>
|
||||
#include <iostream>
|
||||
#include <cmath>
|
||||
|
||||
using namespace std;
|
||||
|
||||
const int N = 6e5 + 10, M = 25 * N;
|
||||
int s[N];
|
||||
int tr[M][2], ver[M];
|
||||
int root[N], idx;
|
||||
|
||||
void insert(int k, int p, int q) {
|
||||
for (int i = 23; ~i; i--) {
|
||||
int u = s[k] >> i & 1;
|
||||
tr[q][u ^ 1] = tr[p][u ^ 1]; //复制
|
||||
tr[q][u] = ++idx; //创建
|
||||
ver[tr[q][u]] = k; //记录版本
|
||||
q = tr[q][u], p = tr[p][u];
|
||||
}
|
||||
}
|
||||
|
||||
int query(int p, int l, int c) {
|
||||
for (int i = 23; ~i ; i--) {
|
||||
int u = c >> i & 1;
|
||||
if (tr[p][u ^ 1] && ver[tr[p][u ^ 1]] >= l)
|
||||
p = tr[p][u ^ 1];
|
||||
else
|
||||
p = tr[p][u];
|
||||
}
|
||||
return c ^ s[ver[p]]; // p:最终停留在的异或和最大值终点处,ver[p]这是哪个版本放进来的?,s[ver[p]]=S_{p-1}
|
||||
}
|
||||
|
||||
int main() {
|
||||
ios::sync_with_stdio(false), cin.tie(0);
|
||||
int n, m;
|
||||
cin >> n >> m;
|
||||
|
||||
// 0号版本,用于处理类似于S[1]-S[0]这样的递推边界值
|
||||
root[0] = ++idx;
|
||||
insert(0, 0, root[0]);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int x;
|
||||
cin >> x;
|
||||
root[i] = ++idx;
|
||||
s[i] = s[i - 1] ^ x; //原数组不重要,异或前缀和数组才重要
|
||||
insert(i, root[i - 1], root[i]);
|
||||
}
|
||||
|
||||
while (m--) {
|
||||
char op;
|
||||
cin >> op;
|
||||
if (op == 'A') {
|
||||
int x;
|
||||
cin >> x;
|
||||
n++;
|
||||
|
||||
root[n] = ++idx;
|
||||
s[n] = s[n - 1] ^ x;
|
||||
insert(n, root[n - 1], root[n]);
|
||||
} else {
|
||||
int l, r, x;
|
||||
cin >> l >> r >> x;
|
||||
printf("%d\n", query(root[r - 1], l - 1, s[n] ^ x));
|
||||
}
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
105
TangDou/AcWing/Trie/835.md
Normal file
105
TangDou/AcWing/Trie/835.md
Normal file
@@ -0,0 +1,105 @@
|
||||
##[$AcWing$ $835$. $Trie$字符串统计](https://www.acwing.com/problem/content/description/837/)
|
||||
|
||||
### 一、题目描述
|
||||
维护一个字符串集合,支持两种操作:
|
||||
|
||||
`I x` 向集合中插入一个字符串 $x$;
|
||||
`Q x` 询问一个字符串在集合中出现了多少次。
|
||||
|
||||
共有 $N$ 个操作,所有输入的字符串总长度不超过 $10^5$,字符串仅包含小写英文字母。
|
||||
|
||||
**输入格式**
|
||||
第一行包含整数 $N$,表示操作数。
|
||||
|
||||
接下来 $N$ 行,每行包含一个操作指令,指令为 `I x` 或 `Q x` 中的一种。
|
||||
|
||||
**输出格式**
|
||||
对于每个询问指令`Q x`,都要输出一个整数作为结果,表示 `x` 在集合中出现的次数。
|
||||
|
||||
每个结果占一行。
|
||||
|
||||
**数据范围**
|
||||
$1≤N≤2∗10^4$
|
||||
|
||||
**输入样例:**
|
||||
```cpp {.line-numbers}
|
||||
5
|
||||
I abc
|
||||
Q abc
|
||||
Q ab
|
||||
I ab
|
||||
Q ab
|
||||
```
|
||||
|
||||
**输出样例:**
|
||||
```cpp {.line-numbers}
|
||||
1
|
||||
0
|
||||
1
|
||||
```
|
||||
|
||||
### 二、什么是$Trie$树
|
||||
$Trie$树又称字典树、单词查找树。是一种能够高效存储和查找字符串集合的数据结构。咋看之下不是很复杂,但是仔细看代码又有点模糊。储存形式如下:
|
||||
|
||||
<center><img src='https://cdn.acwing.com/media/article/image/2020/06/13/31041_aa11ff2cad-Trie1.PNG'></center>
|
||||
|
||||
|
||||
|
||||
**总结**
|
||||
* $tr[N][26]$来描述$Trie$树,**第一维是构建$Trie$树的字符串的总长度,第二维是指$a\sim z$共26种可能**。
|
||||
|
||||
* $tr[i][j]=k$是指节点$i$通过$j$这条边(比如$a$,就是$j=0$,$b$就是$j=1$...),值$k$是指到达了哪个子节点。
|
||||
|
||||
|
||||
**$Trie$ 树的以下几个特点:**
|
||||
|
||||
具有相同前缀的词必须位于同一个串内;例如“清华”、“清新”两个词都有“清”这个前缀,那么在 $Trie$ 树上只需构建一个“清”节点,“华”和“新”节点共用一个父节点即可,如此两个词便只需三个节点便可存储,这在一定程度上减少了字典的存储空间。
|
||||
|
||||
$Trie$ 树中的词只可共用前缀,不可共用词的其他部分;例如“中华”、“华人”这两个词虽然前一个词的后缀是后一个词的前缀,但在树形上必须是独立的两条链路,而不可以通过首尾交接构建这两个词,这也说明 $Trie$ 树仅能依靠公共前缀压缩字典的存储空间,并不能共享词中的所有相同的字符;当然,这一点也有“例外”,对于复合词,可能会出现两词首尾交接的假象,比如“清华大学”这个词在上例 $Trie$ 树中看起来似乎是由“清华”、“大学”两词首尾交接而成,但是叶子节点的标识已经明确说明 $Trie$ 树里面只有”清华“和”清华大学“两个词,它们之间共用了前缀,而非由“清华”和”大学“两词首尾交接所得,因此上例 $Trie$ 树中若需要“大学”这个词则必须从根节点开始重新构建该词。
|
||||
|
||||
$Trie$ 树中任何一个完整的词,都必须是从根节点开始至叶子节点结束,这意味着对一个词进行检索也必须从根节点开始,至叶子节点才算结束。
|
||||
|
||||
### 三、本题答案
|
||||
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
const int N = 1e5 + 10;
|
||||
int tr[N][26], idx, cnt[N];
|
||||
|
||||
void insert(string str) {
|
||||
int p = 0;
|
||||
for (int i = 0; i < str.size(); i++) {
|
||||
int u = str[i] - 'a';
|
||||
if (!tr[p][u]) tr[p][u] = ++idx;
|
||||
p = tr[p][u];
|
||||
}
|
||||
cnt[p]++;
|
||||
}
|
||||
|
||||
int query(string str) {
|
||||
int p = 0;
|
||||
for (int i = 0; i < str.size(); i++) {
|
||||
int u = str[i] - 'a';
|
||||
if (!tr[p][u]) return 0;
|
||||
p = tr[p][u];
|
||||
}
|
||||
return cnt[p];
|
||||
}
|
||||
|
||||
int main() {
|
||||
int n;
|
||||
cin >> n;
|
||||
while (n--) {
|
||||
char op;
|
||||
string str;
|
||||
cin >> op >> str;
|
||||
if (op == 'I')
|
||||
insert(str);
|
||||
else
|
||||
printf("%d\n", query(str));
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
BIN
TangDou/AcWing/Trie/835.vsdx
Normal file
BIN
TangDou/AcWing/Trie/835.vsdx
Normal file
Binary file not shown.
51
TangDou/AcWing/Trie/835_0.cpp
Normal file
51
TangDou/AcWing/Trie/835_0.cpp
Normal file
@@ -0,0 +1,51 @@
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
const int N = 100010;
|
||||
int tr[N][26];
|
||||
int cnt[N];
|
||||
int idx;
|
||||
|
||||
// 插入
|
||||
void insert(string str) {
|
||||
int p = 0; // 游动的节点编号
|
||||
for (int i = 0; i < str.size(); i++) {
|
||||
int u = str[i] - 'a'; // 边
|
||||
if (!tr[p][u]) tr[p][u] = ++idx;
|
||||
p = tr[p][u];
|
||||
}
|
||||
cnt[p]++;
|
||||
}
|
||||
|
||||
/**
|
||||
测试用例:
|
||||
8
|
||||
abcdef
|
||||
abdef
|
||||
aced
|
||||
bcdf
|
||||
bcff
|
||||
cdaa
|
||||
abc
|
||||
bcdc
|
||||
*/
|
||||
|
||||
int main() {
|
||||
int n;
|
||||
cin >> n;
|
||||
while (n--) {
|
||||
// 输入的字符串
|
||||
string str;
|
||||
cin >> str;
|
||||
// 插入到Trie树
|
||||
insert(str);
|
||||
}
|
||||
|
||||
printf("Node Count:%d\n", idx);
|
||||
for (int i = 0; i <= idx; i++)
|
||||
for (int j = 0; j < 26; j++)
|
||||
if (tr[i][j])
|
||||
printf("%d-> %c -> %d\n", i, 'a' + j, tr[i][j]);
|
||||
|
||||
return 0;
|
||||
}
|
||||
40
TangDou/AcWing/Trie/835_1.cpp
Normal file
40
TangDou/AcWing/Trie/835_1.cpp
Normal file
@@ -0,0 +1,40 @@
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
const int N = 1e5 + 10;
|
||||
int tr[N][26], idx, cnt[N];
|
||||
|
||||
void insert(string str) {
|
||||
int p = 0;
|
||||
for (int i = 0; i < str.size(); i++) {
|
||||
int u = str[i] - 'a';
|
||||
if (!tr[p][u]) tr[p][u] = ++idx;
|
||||
p = tr[p][u];
|
||||
}
|
||||
cnt[p]++;
|
||||
}
|
||||
|
||||
int query(string str) {
|
||||
int p = 0;
|
||||
for (int i = 0; i < str.size(); i++) {
|
||||
int u = str[i] - 'a';
|
||||
if (!tr[p][u]) return 0;
|
||||
p = tr[p][u];
|
||||
}
|
||||
return cnt[p];
|
||||
}
|
||||
|
||||
int main() {
|
||||
int n;
|
||||
cin >> n;
|
||||
while (n--) {
|
||||
char op;
|
||||
string str;
|
||||
cin >> op >> str;
|
||||
if (op == 'I')
|
||||
insert(str);
|
||||
else
|
||||
printf("%d\n", query(str));
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
Reference in New Issue
Block a user