'commit'
This commit is contained in:
 HuangHai
BIN
TangDou/JiShuanKe/2023-03-10/.DS_Store
vendored
Normal file
BIN
TangDou/JiShuanKe/2023-03-10/.DS_Store
vendored
Normal file
Binary file not shown.
202
TangDou/JiShuanKe/2023-03-10/T3668.md
Normal file
202
TangDou/JiShuanKe/2023-03-10/T3668.md
Normal file
@@ -0,0 +1,202 @@
|
||||
## [计蒜客 $T3668$ $Eye$ $of$ $the$ $Storm$](https://www.jisuanke.com/problem/T3668)
|
||||
### 一、题目描述
|
||||
云浅来到了风暴的中心。这里漂浮着一个长为 $n$ 的,由小写字母组成的字符串 $S$。**字符串的下标从 $1$ 开始。**
|
||||
|
||||
想要逃出风暴,就需要回答一些询问。
|
||||
|
||||
每次询问会给出一对正整数 $l,r$ 和一个字符串 $T$,云浅需要回答 $S_{l\cdots r}$ 这段子串内有多少个子序列是 $T$。**这里保证 $T$ 的长度为 $2$。**
|
||||
|
||||
形式化地,你需要求出有多少对 $(i,j)$ 满足 $l\le i<j\le r$,使得 $S_i=T_1,S_j=T_2$。
|
||||
|
||||
现在云浅预测出了风暴在接下来 $q$ 个时刻内的询问,你需要帮她求出每个询问的答案。
|
||||
|
||||
### 输入格式
|
||||
|
||||
第一行两个正整数 $n,q$。
|
||||
|
||||
第二行一个长为 $n$ 的字符串 $S$。
|
||||
|
||||
接下来 $q$ 行,每行会给出两个正整数 $l,r$ 和一个字符串 $T$,表示云浅需要回答的询问。保证 $|T|=2$。
|
||||
|
||||
### 输出格式
|
||||
|
||||
对于每次询问,输出一行一个正整数表示答案。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于 $100\%$ 的数据,$1\le n,q\le 2\times 10^5,1\le l\le r\le n,S,T$ 中只含小写英文字母,$|T|=2$。
|
||||
|
||||
| 测试点编号 | $n$ | $q$ | 其他 |
|
||||
| :---------: | :----------------: | :----------------: | :-----------------: |
|
||||
| $1\sim 4$ | $\le 100$ | $\le 100$ | 无 |
|
||||
| $5\sim 8$ | $\le 5000$ | $\le 5000$ | 无 |
|
||||
| $9\sim 10$ | $\le 10^5$ | $\le 10^5$ | 所有的 $S_i$ 均相同 |
|
||||
| $11\sim 12$ | $\le 10^5$ | $\le 3$ | 无 |
|
||||
| $13\sim 16$ | $\le 10^5$ | $\le 10^5$ | 无 |
|
||||
| $17\sim 20$ | $\le 2\times 10^5$ | $\le 2\times 10^5$ | 无 |
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
|
||||
### 二、思路
|
||||
#### 方法一
|
||||
暴力循环 $[l,r]$,判断是否满足题意的数量,复杂度 $O(n^2q)$
|
||||
|
||||
#### 方法二
|
||||
对于上面的方法,显然,其实我们可以只枚举有多少个满足 $S_j=T_2$,那么有多少个 $i$
|
||||
满足 $S_i=T_1$ 是可以用前缀和预处理后 $O(1)$ 算出来的。复杂度 $O(nq)$
|
||||
|
||||
#### 方法三
|
||||
这种方法是对方法二的一种小优化。
|
||||
|
||||
我们在枚举有多少个满足 $S_j=T_2$
|
||||
时,我们其实是可以把 $S_i$ 按字母分成$26$类,在每一类中分别枚举的,这个过程可以用`vector`辅助实现。
|
||||
|
||||
#### 方法四
|
||||
我们对方法三进行优化。
|
||||
|
||||
我们既然已经把 $S_i$ 分类了,而我们要求的是 $[l,r]$ 区间,我们就可以对分类后的 $S_i$ 作个前缀和,然后二分即可。复杂度 $O(qlogn)$
|
||||
|
||||
实现上有一些小细节要注意
|
||||
|
||||
### 三、$STL$二分版本
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int N = 2e5 + 10;
|
||||
|
||||
int n, m; // n个长度的原串,m个询问
|
||||
char S[N]; // 原串
|
||||
vector<int> p[26]; // 记录每个字符出现的位置,比如'a'出现在位置1,3,5,...
|
||||
vector<int> f[26][26]; // 三维数组,从谁,二维:到谁,三维:第几次出现,值:有多少个从谁
|
||||
int s[N][26]; // 分类前缀和
|
||||
|
||||
// 使用STL版本的lower_bound,upper_bound
|
||||
int main() {
|
||||
freopen("ridge.in", "r", stdin);
|
||||
freopen("ridge.out", "w", stdout);
|
||||
|
||||
cin >> n >> m >> (S + 1);
|
||||
/* (1)因为题目数据范围很大,只能用O(NlogN)的时间复杂度(或更低)才能过掉,所以在输入数据时,必须千方百计的预处理提高性能
|
||||
(2)从最后询问的问题来思考,设原串为S,开始字符为x、结束字符为y:
|
||||
① 预处理出S中每个字符出现的位置p[],在询问时可以只枚举有用的位置,例:p[0]={2,4} 表示'a'出现在2,4两个位置。
|
||||
② 预处理出S中每个字符出现的次数s[],可以用前缀和,例:s[10][0]=3 表示在S的前10个字符中,'a'字符出现了3次。
|
||||
只有上面两个预处理出的数组还不行,因为串中可能多次出现a和b,但有些a在b后面,直接使用①②是不对的。
|
||||
③ 预处理出:每当y出现时,记录前面已经出现过了多少个x,用数组vector<int> f[][][]来表示:
|
||||
第一维代表是26个可能的来源字符x
|
||||
第二维代表是26个可能的终止字符y
|
||||
第三维代表是:第一次出现,第二次出现,....
|
||||
值:x之前出现次数
|
||||
④ 以f[][][]为基础数据,再次三层循环累加起来的值,表示:第k次出现时,前k个y与前面所有x的配对数量,是一个累加前缀和概念。
|
||||
*/
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int y = S[i] - 'a'; // 当前字符y
|
||||
for (int x = 0; x < 26; x++) {
|
||||
s[i][x] = s[i - 1][x];
|
||||
f[x][y].push_back(s[i][x]); // x是肯定有的,每回26个,y是因为看到了当前的字符y。换句话说:就是y出来一次,就push_back了26个x的统计数据
|
||||
}
|
||||
p[y].push_back(i); // 字符y出现在i这个位置上
|
||||
s[i][y]++; // 前i个字符中,字符y出现的次数增加了1个
|
||||
}
|
||||
|
||||
// 计算区间前缀和
|
||||
for (int i = 0; i < 26; i++) // 从字符i
|
||||
for (int j = 0; j < 26; j++) // 到字符j
|
||||
for (int k = 1; k < (int)f[i][j].size(); k++) // 有多条记录
|
||||
f[i][j][k] += f[i][j][k - 1]; // 生成前缀和
|
||||
|
||||
while (m--) {
|
||||
int l, r;
|
||||
string t;
|
||||
cin >> l >> r >> t;
|
||||
|
||||
int x = t[0] - 'a', y = t[1] - 'a';
|
||||
int ql = lower_bound(p[y].begin(), p[y].end(), l) - p[y].begin(); // y的左边界
|
||||
int qr = upper_bound(p[y].begin(), p[y].end(), r) - p[y].begin() - 1; // y的右边界
|
||||
if (ql > qr) { // 如果没有找到y,输出0
|
||||
cout << 0 << endl;
|
||||
continue;
|
||||
}
|
||||
int cnt = qr - ql + 1; // y的个数
|
||||
// 两层前缀和
|
||||
// 以y的右边界结尾,计算y_右与前面所有x的配对数量=f[x][y][qr]
|
||||
// 以y的左边界结尾,计算y_右与前面所有x的配对数量=f[x][y][ql - 1]
|
||||
// 两者的差,还需要继续减去前l-1个中存在的x与[l,r]区间内的y的配对关系数量
|
||||
// 需要注意的是:因为使用的是vector,下标从0开始,如果直接使用ql-1可能会有下标为负数的风险,需要判断一下
|
||||
cout << f[x][y][qr] - (ql == 0 ? 0 : f[x][y][ql - 1]) - s[l - 1][x] * cnt << endl;
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
### 四、手写二分版本
|
||||
```cpp {.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int N = 2e5 + 10;
|
||||
|
||||
int n, m;
|
||||
char S[N];
|
||||
vector<int> p[26];
|
||||
vector<int> f[26][26];
|
||||
int s[N][26];
|
||||
|
||||
int lower_bound(vector<int> q, int l, int r, int x) {
|
||||
while (l < r) {
|
||||
int mid = (l + r) >> 1;
|
||||
if (q[mid] >= x)
|
||||
r = mid;
|
||||
else
|
||||
l = mid + 1;
|
||||
}
|
||||
return l;
|
||||
}
|
||||
int upper_bound(vector<int> q, int l, int r, int x) {
|
||||
while (l < r) {
|
||||
int mid = (l + r) >> 1;
|
||||
if (q[mid] > x)
|
||||
r = mid;
|
||||
else
|
||||
l = mid + 1;
|
||||
}
|
||||
return l;
|
||||
}
|
||||
|
||||
// 使用手写版本的lower_bound,upper_bound
|
||||
int main() {
|
||||
freopen("ridge.in", "r", stdin);
|
||||
freopen("ridge.out", "w", stdout);
|
||||
|
||||
cin >> n >> m >> (S + 1);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int y = S[i] - 'a';
|
||||
for (int x = 0; x < 26; x++) {
|
||||
s[i][x] = s[i - 1][x];
|
||||
f[x][y].push_back(s[i][x]);
|
||||
}
|
||||
p[y].push_back(i);
|
||||
s[i][y]++;
|
||||
}
|
||||
for (int i = 0; i < 26; i++)
|
||||
for (int j = 0; j < 26; j++)
|
||||
for (int k = 1; k < (int)f[i][j].size(); k++)
|
||||
f[i][j][k] += f[i][j][k - 1];
|
||||
|
||||
while (m--) {
|
||||
int l, r;
|
||||
string t;
|
||||
cin >> l >> r >> t;
|
||||
|
||||
int x = t[0] - 'a', y = t[1] - 'a';
|
||||
int ql = lower_bound(p[y], 0, (int)p[y].size(), l);
|
||||
int qr = upper_bound(p[y], 0, (int)p[y].size(), r) - 1;
|
||||
if (ql > qr) {
|
||||
cout << 0 << endl;
|
||||
continue;
|
||||
}
|
||||
int cnt = qr - ql + 1;
|
||||
cout << f[x][y][qr] - (ql == 0 ? 0 : f[x][y][ql - 1]) - s[l - 1][x] * cnt << endl;
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
66
TangDou/JiShuanKe/2023-03-10/T3668_1.cpp
Normal file
66
TangDou/JiShuanKe/2023-03-10/T3668_1.cpp
Normal file
@@ -0,0 +1,66 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int N = 2e5 + 10;
|
||||
|
||||
int n, m; // n个长度的原串,m个询问
|
||||
char S[N]; // 原串
|
||||
vector<int> p[26]; // 记录每个字符出现的位置,比如'a'出现在位置1,3,5,...
|
||||
vector<int> f[26][26]; // 三维数组,从谁,二维:到谁,三维:第几次出现,值:有多少个从谁
|
||||
int s[N][26]; // 分类前缀和
|
||||
|
||||
// 使用STL版本的lower_bound,upper_bound
|
||||
int main() {
|
||||
freopen("ridge.in", "r", stdin);
|
||||
freopen("ridge.out", "w", stdout);
|
||||
|
||||
cin >> n >> m >> (S + 1);
|
||||
/* (1)因为题目数据范围很大,只能用O(NlogN)的时间复杂度(或更低)才能过掉,所以在输入数据时,必须千方百计的预处理提高性能
|
||||
(2)从最后询问的问题来思考,设原串为S,开始字符为x、结束字符为y:
|
||||
① 预处理出S中每个字符出现的位置p[],在询问时可以只枚举有用的位置,例:p[0]={2,4} 表示'a'出现在2,4两个位置。
|
||||
② 预处理出S中每个字符出现的次数s[],可以用前缀和,例:s[10][0]=3 表示在S的前10个字符中,'a'字符出现了3次。
|
||||
只有上面两个预处理出的数组还不行,因为串中可能多次出现a和b,但有些a在b后面,直接使用①②是不对的。
|
||||
③ 预处理出:每当y出现时,记录前面已经出现过了多少个x,用数组vector<int> f[][][]来表示:
|
||||
第一维代表是26个可能的来源字符x
|
||||
第二维代表是26个可能的终止字符y
|
||||
第三维代表是:第一次出现,第二次出现,....
|
||||
值:x之前出现次数
|
||||
④ 以f[][][]为基础数据,再次三层循环累加起来的值,表示:第k次出现时,前k个y与前面所有x的配对数量,是一个累加前缀和概念。
|
||||
*/
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int y = S[i] - 'a'; // 当前字符y
|
||||
for (int x = 0; x < 26; x++) {
|
||||
s[i][x] = s[i - 1][x];
|
||||
f[x][y].push_back(s[i][x]); // x是肯定有的,每回26个,y是因为看到了当前的字符y。换句话说:就是y出来一次,就push_back了26个x的统计数据
|
||||
}
|
||||
p[y].push_back(i); // 字符y出现在i这个位置上
|
||||
s[i][y]++; // 前i个字符中,字符y出现的次数增加了1个
|
||||
}
|
||||
|
||||
// 计算区间前缀和
|
||||
for (int i = 0; i < 26; i++) // 从字符i
|
||||
for (int j = 0; j < 26; j++) // 到字符j
|
||||
for (int k = 1; k < (int)f[i][j].size(); k++) // 有多条记录
|
||||
f[i][j][k] += f[i][j][k - 1]; // 生成前缀和
|
||||
|
||||
while (m--) {
|
||||
int l, r;
|
||||
string t;
|
||||
cin >> l >> r >> t;
|
||||
|
||||
int x = t[0] - 'a', y = t[1] - 'a';
|
||||
int ql = lower_bound(p[y].begin(), p[y].end(), l) - p[y].begin(); // y的左边界
|
||||
int qr = upper_bound(p[y].begin(), p[y].end(), r) - p[y].begin() - 1; // y的右边界
|
||||
if (ql > qr) { // 如果没有找到y,输出0
|
||||
cout << 0 << endl;
|
||||
continue;
|
||||
}
|
||||
int cnt = qr - ql + 1; // y的个数
|
||||
// 两层前缀和
|
||||
// 以y的右边界结尾,计算y_右与前面所有x的配对数量=f[x][y][qr]
|
||||
// 以y的左边界结尾,计算y_右与前面所有x的配对数量=f[x][y][ql - 1]
|
||||
// 两者的差,还需要继续减去前l-1个中存在的x与[l,r]区间内的y的配对关系数量
|
||||
// 需要注意的是:因为使用的是vector,下标从0开始,如果直接使用ql-1可能会有下标为负数的风险,需要判断一下
|
||||
cout << f[x][y][qr] - (ql == 0 ? 0 : f[x][y][ql - 1]) - s[l - 1][x] * cnt << endl;
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
69
TangDou/JiShuanKe/2023-03-10/T3668_2.cpp
Normal file
69
TangDou/JiShuanKe/2023-03-10/T3668_2.cpp
Normal file
@@ -0,0 +1,69 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int N = 2e5 + 10;
|
||||
|
||||
int n, m;
|
||||
char S[N];
|
||||
vector<int> p[26];
|
||||
vector<int> f[26][26];
|
||||
int s[N][26];
|
||||
|
||||
int lower_bound(vector<int> q, int l, int r, int x) {
|
||||
while (l < r) {
|
||||
int mid = (l + r) >> 1;
|
||||
if (q[mid] >= x)
|
||||
r = mid;
|
||||
else
|
||||
l = mid + 1;
|
||||
}
|
||||
return l;
|
||||
}
|
||||
int upper_bound(vector<int> q, int l, int r, int x) {
|
||||
while (l < r) {
|
||||
int mid = (l + r) >> 1;
|
||||
if (q[mid] > x)
|
||||
r = mid;
|
||||
else
|
||||
l = mid + 1;
|
||||
}
|
||||
return l;
|
||||
}
|
||||
|
||||
// 使用手写版本的lower_bound,upper_bound
|
||||
int main() {
|
||||
freopen("ridge.in", "r", stdin);
|
||||
freopen("ridge.out", "w", stdout);
|
||||
|
||||
cin >> n >> m >> (S + 1);
|
||||
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int y = S[i] - 'a';
|
||||
for (int x = 0; x < 26; x++) {
|
||||
s[i][x] = s[i - 1][x];
|
||||
f[x][y].push_back(s[i][x]);
|
||||
}
|
||||
p[y].push_back(i);
|
||||
s[i][y]++;
|
||||
}
|
||||
for (int i = 0; i < 26; i++)
|
||||
for (int j = 0; j < 26; j++)
|
||||
for (int k = 1; k < (int)f[i][j].size(); k++)
|
||||
f[i][j][k] += f[i][j][k - 1];
|
||||
|
||||
while (m--) {
|
||||
int l, r;
|
||||
string t;
|
||||
cin >> l >> r >> t;
|
||||
|
||||
int x = t[0] - 'a', y = t[1] - 'a';
|
||||
int ql = lower_bound(p[y], 0, (int)p[y].size(), l);
|
||||
int qr = upper_bound(p[y], 0, (int)p[y].size(), r) - 1;
|
||||
if (ql > qr) {
|
||||
cout << 0 << endl;
|
||||
continue;
|
||||
}
|
||||
int cnt = qr - ql + 1;
|
||||
cout << f[x][y][qr] - (ql == 0 ? 0 : f[x][y][ql - 1]) - s[l - 1][x] * cnt << endl;
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
49
TangDou/JiShuanKe/2023-03-10/T3703.cpp
Normal file
49
TangDou/JiShuanKe/2023-03-10/T3703.cpp
Normal file
@@ -0,0 +1,49 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int N = 1e6 + 10;
|
||||
const int mod = 998244353;
|
||||
int n, f[N];
|
||||
int fac[N << 1];
|
||||
int inv[N << 1];
|
||||
|
||||
// TODO
|
||||
// 待复习完卡特兰数时,当做练习题来再次做这道题
|
||||
// 2023-03-14
|
||||
int qmi(int a, int b, int mod) {
|
||||
a %= mod;
|
||||
if (!a) return 0;
|
||||
int result = 1;
|
||||
for (; b; a = 1ll * a * a % mod, b >>= 1) {
|
||||
if (b & 1) result = 1ll * result * a % mod;
|
||||
}
|
||||
return result;
|
||||
}
|
||||
|
||||
int C(const int n, const int m) {
|
||||
if (n < m) return 0;
|
||||
return 1ll * fac[n] * inv[m] % mod * inv[n - m] % mod;
|
||||
}
|
||||
|
||||
int cal(int a, int b) {
|
||||
return (1ll * C(a + 2 * b, b) - C(a + 2 * b, b - 1) + mod) % mod;
|
||||
}
|
||||
|
||||
void init(const int n) {
|
||||
fac[0] = 1;
|
||||
for (int i = 1; i <= n; i++) fac[i] = 1ll * fac[i - 1] * i % mod;
|
||||
inv[n] = qmi(fac[n], mod - 2, mod);
|
||||
for (int i = n - 1; i >= 0; i--) inv[i] = inv[i + 1] * (i + 1ll) % mod;
|
||||
}
|
||||
int main() {
|
||||
freopen("stack.in", "r", stdin);
|
||||
freopen("stack.out", "w", stdout);
|
||||
cin >> n;
|
||||
init(n << 1);
|
||||
for (int i = 1; i <= n; i++) cin >> f[i];
|
||||
int ans = 0;
|
||||
for (int i = 1; i <= n; i++)
|
||||
if (f[i]) ans = (ans + cal(i - 1, n - i)) % mod;
|
||||
|
||||
cout << ans << endl;
|
||||
return 0;
|
||||
}
|
||||
19
TangDou/JiShuanKe/2023-03-10/T3706.cpp
Normal file
19
TangDou/JiShuanKe/2023-03-10/T3706.cpp
Normal file
@@ -0,0 +1,19 @@
|
||||
#include <bits/stdc++.h>
|
||||
|
||||
using namespace std;
|
||||
int n;
|
||||
string s;
|
||||
int res;
|
||||
|
||||
int main() {
|
||||
cin >> n >> s;
|
||||
for (int i = 0; i < (int)s.size(); i++)
|
||||
for (int j = i + 1; j < (int)s.size(); j++) {
|
||||
if (s[i] == s[j]) {
|
||||
res = max(res, j - i);
|
||||
break;
|
||||
}
|
||||
}
|
||||
cout << res << endl;
|
||||
return 0;
|
||||
}
|
||||
3
TangDou/JiShuanKe/2023-03-10/ridge.in
Normal file
3
TangDou/JiShuanKe/2023-03-10/ridge.in
Normal file
@@ -0,0 +1,3 @@
|
||||
10 1
|
||||
yunqianqwq
|
||||
2 7 un
|
||||
1
TangDou/JiShuanKe/2023-03-10/ridge.out
Normal file
1
TangDou/JiShuanKe/2023-03-10/ridge.out
Normal file
@@ -0,0 +1 @@
|
||||
2
|
||||
84
TangDou/JiShuanKe/2023-03-10/入门简单题.md
Normal file
84
TangDou/JiShuanKe/2023-03-10/入门简单题.md
Normal file
@@ -0,0 +1,84 @@
|
||||
# 距离
|
||||
|
||||
### 题目描述
|
||||
蒜头君最近获得了一个字符串 `str`,这个字符串只由**小写字母**构成。
|
||||
|
||||
蒜头君不仅是一个数学能手,英语学的更是不错,他对于 $26$ 个英文字母非常敏感。
|
||||
|
||||
蒜头君发现,相同字母(如果存在)在字符串中有一个距离,比如字符串 `abca`,字母 `a` 的距离为 $3$(索引之差的绝对值)。
|
||||
|
||||
距离的定义:字符串中相对位置相邻的两个相同字母之间的距离。如果位置 $i$ 的字母与位置 $j(i < j)$ 的字母之间存在距离,那么需要满足 `str[i] == str[j]` 且 $i+1 \sim j - 1$ 之间可以有其他字母但是不能有与 `str[i]` 相同的字母。
|
||||
|
||||
对于字符串 `abcasdva`,则有三个字母 `a`,第一个 $a$ 和第二个 `a` 之间的距离为 $3$,第二个 `a` 和第三个 `a` 之间的距离为 $4$。第一个 `a` 和第三个 `a` 之间**没有距离**。
|
||||
|
||||
现在蒜头君把他的字符串给你了,你能够找到字符串字母之间的**最大距离**吗?
|
||||
|
||||
如果字符串中,所有的字母都不相同,那么最大距离为 $0$。
|
||||
|
||||
### 输入格式
|
||||
|
||||
输入共两行。
|
||||
|
||||
第一行输入一个正整数 $n$,表示字符串的长度。
|
||||
|
||||
第二行输入一个长度为 $n$ 的字符串 $str$。
|
||||
|
||||
### 输出格式
|
||||
|
||||
输出共一行。
|
||||
|
||||
输出一个数,表示字符串字母之间的最大距离。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于 $10\%$ 的数据,有 $1\leq n\leq 10$,且字符串中的字母互不相同。
|
||||
|
||||
对于另外 $20\%$ 的数据,有 $1\leq n\leq 100$,且字符串中只有两种字母。
|
||||
|
||||
对于 $100\%$ 的数据,有 $1\leq n\leq 10^3$。
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
|
||||
### 题解
|
||||
依次枚举每一个字母,然后寻找**下一个**与它相同的字母,并且维护距离的最大值。
|
||||
|
||||
注意,如果找到下一个与该字母相同的字母,维护后就需要通过`break`结束当前寻找的循环。
|
||||
|
||||
```c++
|
||||
int ans = 0;
|
||||
for (int i = 0; i < n; i++) {
|
||||
for (int j = i + 1; j < n; j++) {
|
||||
if (str[i] == str[j]) {
|
||||
ans = max(ans, j - i);
|
||||
break; // 注意这个 break
|
||||
}
|
||||
}
|
||||
}
|
||||
```
|
||||
|
||||
|
||||
#### 参考代码
|
||||
|
||||
```c++{.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
int main() {
|
||||
int n;
|
||||
string str;
|
||||
cin >> n;
|
||||
cin >> str;
|
||||
int ans = 0;
|
||||
for (int i = 0; i < n; i++) {
|
||||
for (int j = i + 1; j < n; j++) {
|
||||
if (str[i] == str[j]) {
|
||||
ans = max(ans, j - i);
|
||||
break;
|
||||
}
|
||||
}
|
||||
}
|
||||
cout << ans << endl;
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
120
TangDou/JiShuanKe/2023-03-10/提高挑战题.md
Normal file
120
TangDou/JiShuanKe/2023-03-10/提高挑战题.md
Normal file
@@ -0,0 +1,120 @@
|
||||
# $stack$
|
||||
|
||||
### 题目描述
|
||||
小 $\mathcal{L}$ 有一个栈和一个队列,现在队列中有 $n$ 个**不同**元素,每次可以选择两种操作:
|
||||
|
||||
1. 把队头的元素放到栈顶(如果队列为空则不能进行该操作)
|
||||
2. 把栈顶元素放入输出数组(如果栈为空则不能进行该操作)
|
||||
|
||||
现在总共要进行 $2n$ 次操作,故输出数组长度必然为 $n$。
|
||||
|
||||
小 $\mathcal{L}$ 有强迫症,所以输出数组的第一个位置的元素有必须是自己喜欢的。
|
||||
|
||||
现在给出队列($a_1\sim a_n$ 其中 $a_1$ 为队头)中的元素的属性($a_i$ 为 $1$ 则表示该元素小 $\mathcal{L}$ 喜欢,为 $0$ 则不喜欢),您需要求出符合小 $\mathcal{L}$ 要求的不同的出栈入栈方式的个数,因为结果很大,所以您只需要给出结果 $\bmod 998244353$ 后的结果即可。
|
||||
|
||||
### 输入格式
|
||||
|
||||
输入包含两行。
|
||||
|
||||
第一行输入一个正整数 $n$。
|
||||
|
||||
第二行输入 $n$ 个正整数 $a_1,a_2,...,a_n$。
|
||||
|
||||
### 输出格式
|
||||
|
||||
输出一个正整数表示答案。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于 $20\%$ 的数据 $n\leq 10$。
|
||||
|
||||
对于 $40\%$ 的数组 $n\leq 2333$。
|
||||
|
||||
对于另外 $20\%$ 的数据仅存在 $a_1$ 的值为 $1$。
|
||||
|
||||
对于另外 $20\%$ 的数据仅存在唯一的 $i$,使得 $a_i=1$。
|
||||
|
||||
对于 $100\%$ 的数据 $n\leq1\times 10^6$,$a_i\in\{0,1\}$。
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
|
||||
### 题解
|
||||
首先对于任意一个最终的输出数组可以通过反推,得到一个唯一的操作序列,所以说合法的操作序列与输出数组是一一对应的,也就是说输出数组的种类数等价于合法的操作序列数。所以只需要考虑合法的方案数即可。
|
||||
|
||||
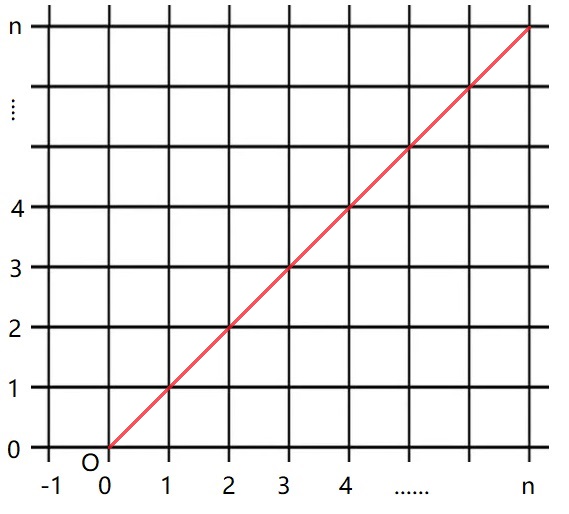
考虑一个合法的输出时如何产生的,因为开头必须为 $1$,所以可以先指定开头的元素,那么要将这个元素前面的元素都先放入栈中,这个元素才能作为第一个。假设这个元素为第 $i$ 个,那么 $1\sim i-1$ 在栈中,$i+1\sim n$ 在队列中。也就是说问题变成了一个栈中已经存在一定元素出出栈序列数。考虑一个经典的转化,出栈数计数这类问题可以放到方格图中,如下
|
||||
|
||||
|
||||
|
||||
其中经典的 $n$ 不同元素出栈序列问题是从 $(0,0)$ 出发到 $(n,n)$,但是不能到红线上方的区域的方案数。也就是将入栈等同于向右走,出栈等同于向上走,因为要保证在任意一个出栈操作前已经有入栈的个数必须大于出栈的个数所以存在红线的限制。
|
||||
|
||||
|
||||
|
||||
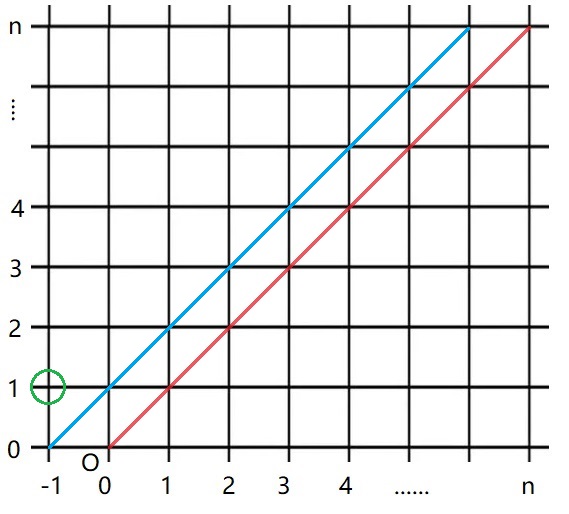
要解决这个问题。可以发现对于任意的越过红线的方案都会经过蓝线,所以考虑那些不合法的方案,也就是必定经过蓝线的方案。找到起点 $(0,0)$ 关于蓝线的对称点 $(-1,1)$,可以发现从 $(-1,1)$ 除法的每一条到 $(n,n)$ 的路径都会经过蓝线,再将所有这些路径以第一次经过蓝线上的点为界限将前面按蓝线对称,这样起点又边了 $(0,0)$,并且不难发现这些方案与那些不合法方案是一一对应的(不理解的话可以自己画几条路径,总能找到为一条从 $(-1,1)$ 出发的路径按上述方法与之对应)
|
||||
|
||||
于是可以得出 $f(n)={2n\choose n}-{2n\choose n-1}=\frac{2n\choose n}{n+1}$,也就是著名的 **卡特兰数**。
|
||||
|
||||
现在相当于起点位置变成了 $(i-1,0)$ 终点变成了 $(n-1,n-1)$,做法仍然类似,找到起点关于蓝线对称的点,计算其到终点的方案数便是不合法的方案数。对称后点的坐标为 $(-1,i)$,所以答案就是 ${2n-i-1\choose n-1}-{2n-i-1\choose n}$。
|
||||
|
||||
|
||||
#### 参考代码
|
||||
|
||||
```c++{.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int maxn = 1e6 + 10;
|
||||
const int mod = 998244353;
|
||||
int n, f[maxn];
|
||||
int fac[maxn << 1];
|
||||
int inv[maxn << 1];
|
||||
int qmi(int a, int b, int mod) {
|
||||
a %= mod;
|
||||
if (!a) {
|
||||
return 0;
|
||||
}
|
||||
int result = 1;
|
||||
for (; b; a = 1ll * a * a % mod, b >>= 1) {
|
||||
if (b& 1) {
|
||||
result = 1ll * result * a % mod;
|
||||
}
|
||||
}
|
||||
return result;
|
||||
}
|
||||
int C(const int n, const int m) {
|
||||
if (n < m) {
|
||||
return 0;
|
||||
}
|
||||
return 1ll * fac[n] * inv[m] % mod * inv[n - m] % mod;
|
||||
}
|
||||
int cal(int a, int b) {
|
||||
return(1ll * C(a + 2 * b, b) - C(a + 2 * b, b - 1) + mod) % mod;
|
||||
}
|
||||
void init(const int n) {
|
||||
fac[0] = 1;
|
||||
for (int i = 1; i <= n; i++) {
|
||||
fac[i] = 1ll * fac[i - 1] * i % mod;
|
||||
}
|
||||
inv[n] = qmi(fac[n], mod - 2, mod);
|
||||
for (int i = n - 1; i >= 0; i--) {
|
||||
inv[i] = inv[i + 1] * (i + 1ll) % mod;
|
||||
}
|
||||
}
|
||||
int main() {
|
||||
freopen("stack.in", "r", stdin);
|
||||
freopen("stack.out", "w", stdout);
|
||||
scanf("%d", &n);
|
||||
init(n << 1);
|
||||
for (int i = 1; i <= n; i++) {
|
||||
scanf("%d", &f[i]);
|
||||
}
|
||||
int ans = 0;
|
||||
for (int i = 1; i <= n; i++) {
|
||||
if (f[i]) {
|
||||
ans = (ans + cal(i - 1, n - i)) % mod;
|
||||
}
|
||||
}
|
||||
cout << ans << endl;
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
117
TangDou/JiShuanKe/2023-03-10/普及提升题.md
Normal file
117
TangDou/JiShuanKe/2023-03-10/普及提升题.md
Normal file
@@ -0,0 +1,117 @@
|
||||
# Eye of the Storm
|
||||
|
||||
### 题目描述
|
||||
云浅来到了风暴的中心。这里漂浮着一个长为 $n$ 的,由小写字母组成的字符串 $S$。**字符串的下标从 $1$ 开始。**
|
||||
|
||||
想要逃出风暴,就需要回答一些询问。
|
||||
|
||||
每次询问会给出一对正整数 $l,r$ 和一个字符串 $T$,云浅需要回答 $S_{l\cdots r}$ 这段子串内有多少个子序列是 $T$。**这里保证 $T$ 的长度为 $2$。**
|
||||
|
||||
形式化地,你需要求出有多少对 $(i,j)$ 满足 $l\le i<j\le r$,使得 $S_i=T_1,S_j=T_2$。
|
||||
|
||||
现在云浅预测出了风暴在接下来 $q$ 个时刻内的询问,你需要帮她求出每个询问的答案。
|
||||
|
||||
### 输入格式
|
||||
|
||||
第一行两个正整数 $n,q$。
|
||||
|
||||
第二行一个长为 $n$ 的字符串 $S$。
|
||||
|
||||
接下来 $q$ 行,每行会给出两个正整数 $l,r$ 和一个字符串 $T$,表示云浅需要回答的询问。保证 $|T|=2$。
|
||||
|
||||
### 输出格式
|
||||
|
||||
对于每次询问,输出一行一个正整数表示答案。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于 $100\%$ 的数据,$1\le n,q\le 2\times 10^5,1\le l\le r\le n,S,T$ 中只含小写英文字母,$|T|=2$。
|
||||
|
||||
| 测试点编号 | $n$ | $q$ | 其他 |
|
||||
| :-: | :-: | :-: | :-: |
|
||||
| $1\sim 4$ | $\le 100$ | $\le 100$ | 无 |
|
||||
| $5\sim 8$ | $\le 5000$ | $\le 5000$ | 无 |
|
||||
| $9\sim 10$ | $\le 10^5$ | $\le 10^5$ | 所有的 $S_i$ 均相同 |
|
||||
| $11\sim 12$ | $\le 10^5$ | $\le 3$ | 无 |
|
||||
| $13\sim 16$ | $\le 10^5$ | $\le 10^5$ | 无 |
|
||||
| $17\sim 20$ | $\le 2\times 10^5$ | $\le 2\times 10^5$ | 无 |
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
|
||||
### 题解
|
||||
记字符集大小为 $V=26$。
|
||||
|
||||
考虑设 $\text{Sum}(i,c)$ 为 $S_{1\cdots i}$ 中字符 $c$ 的出现次数,那么答案就是$$\displaystyle \sum_{l\le i\le r,S_i==T_2}\text{Sum}(i-1,T_1)-\text{Sum}(l-1,T_1) $$用一个 `vector` 来存一下 $S$ 中等于 $T_2$ 的数的出现位置,顺便附带记录一下 $\text{Sum}$,每次查询的时候二分出 $r$ 前面和 $l$ 后面的第一个满足等于 $S_i==T_2$ 的 $i$ 的位置,那么要求的就是 `vector` 内的一个前缀和。具体可以看代码。
|
||||
|
||||
时间复杂度 $O(nV+q\log n)$,空间复杂度 $O(nV)$。
|
||||
|
||||
|
||||
#### 参考代码
|
||||
|
||||
```c++{.line-numbers}
|
||||
#include <bits/stdc++.h>
|
||||
#define int long long
|
||||
using namespace std;
|
||||
inline int read() {
|
||||
int x = 0, f = 1;
|
||||
char c = getchar();
|
||||
for (; (c < '0' || c > '9'); c = getchar()) {
|
||||
if (c == '-') {
|
||||
f = -1;
|
||||
}
|
||||
}
|
||||
for (; (c >= '0'&& c <= '9'); c = getchar()) {
|
||||
x = x * 10 + (c& 15);
|
||||
}
|
||||
return x * f;
|
||||
}
|
||||
int n, q;
|
||||
string S, T;
|
||||
#define mk make_pair
|
||||
#define fi first
|
||||
#define se second
|
||||
const int MN = 2e5 + 5;
|
||||
vector<int > pos[26], sum[26][26];
|
||||
int f[MN][26];
|
||||
signed main(void) {
|
||||
freopen("ridge.in", "r", stdin);
|
||||
freopen("ridge.out", "w", stdout);
|
||||
cin >> n >> q;
|
||||
cin >> S;
|
||||
for (int i = 1; i <= n; i++) {
|
||||
int t = (int)(S[i - 1] - 'a');
|
||||
for (int x = 0; x < 26; x++) {
|
||||
f[i][x] = f[i - 1][x], sum[t][x].push_back(f[i][x]);
|
||||
}
|
||||
pos[t].push_back(i);
|
||||
f[i][t]++;
|
||||
}
|
||||
for (int t = 0; t < 26; t++) {
|
||||
for (int x = 0; x < 26; x++) {
|
||||
for (int j = 1; j < sum[t][x].size(); j++) {
|
||||
sum[t][x][j] += sum[t][x][j - 1];
|
||||
}
|
||||
}
|
||||
}
|
||||
while (q--) {
|
||||
int l, r;
|
||||
cin >> l >> r >> T;
|
||||
if (l > r) {
|
||||
puts("**");
|
||||
return 0;
|
||||
}
|
||||
int a = T[0] - 'a', b = T[1] - 'a';
|
||||
int ql = lower_bound(pos[b].begin(), pos[b].end(), l) - pos[b].begin();
|
||||
int qr = upper_bound(pos[b].begin(), pos[b].end(), r) - pos[b].begin() - 1;
|
||||
if (ql > qr) {
|
||||
puts("0");
|
||||
continue;
|
||||
}
|
||||
int cnt = qr - ql + 1;
|
||||
cout << sum[b][a][qr] - (ql == 0 ? 0 : sum[b][a][ql - 1]) - f[l - 1][a] * cnt << endl;
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
<div style="page-break-after: always"></div>
|
||||
3
TangDou/JiShuanKe/2023-03-10/题目清单.txt
Normal file
3
TangDou/JiShuanKe/2023-03-10/题目清单.txt
Normal file
@@ -0,0 +1,3 @@
|
||||
入门:https://nanti.jisuanke.com/t/T3706
|
||||
普及:https://nanti.jisuanke.com/t/T3668
|
||||
提高:https://nanti.jisuanke.com/t/T3703
|
||||
Reference in New Issue
Block a user